---
title: "在 CI 中做搜索相关性回归测试"
description: "搜索服务正常运行,也可能把错误答案排在第一位。本文用一个可运行的 Manticore 示例,演示怎样在 CI 中发现相关性回归。"
date: 2026-11-13
author: "Dmitrii Kuzmenkov"
image: https://manticoresearch.com/images/blog/search-relevance-ci.png
lang: zh
url: https://manticoresearch.com/zh/blog/search-relevance-ci/
translations:
en: https://manticoresearch.com/blog/search-relevance-ci/
ru: https://manticoresearch.com/ru/blog/search-relevance-ci/
---
# 在 CI 中做搜索相关性回归测试
搜索服务正常运行,也可能把错误答案排在第一位。本文用一个可运行的 Manticore 示例,演示怎样在 CI 中发现相关性回归。
搜索服务一切正常,用户却在查询 `E403` 权限错误时看到了刷新会话 Token 的说明。查询成功返回了结果,但排在第一位的步骤解决不了问题。
健康检查发现不了这种问题,只统计结果数量的测试也不行。我们需要一些示例问题、明确的正确答案,以及能在 CI 中检查排序的测试。
这里有一个[可运行的 Manticore 示例](./search-relevance-ci/relevance-ci.zip)。我们先比较关键词、向量和混合搜索,再去掉关键词分支。查询仍然有结果,但排序变差,相关性检查以退出码 **1** 结束。下载包包含测试文档、相关性标注、评估脚本、原始引擎响应和 CI 工作流示例。
## 先确定正确答案
之前的[混合搜索文章](/blog/hybrid-search/)和[自动分块文章](/blog/auto-chunking/)讲了怎样构建检索。现在来看另一个问题:改动搜索实现之后,用户还能找到需要的答案吗?
在这个虚构的 API 中,`E403` 表示需要工作区权限,`E401` 表示会话 Token 过期。相似度分数或融合分数再高,也不能证明排在前面的步骤能解决问题。这需要应用自己的相关性判断。
示例使用 12 篇关于虚构 API 错误和运维步骤的短文档。它们不是 Manticore 文档,错误码也是为示例编写的。我们为每条查询写出目标,并给**每篇**文档标上等级:
| 等级 | 在本示例中的含义 |
|---|---|
| 2 | 给出能解决所述意图的步骤 |
| 1 | 相关背景,但不能解决问题 |
| 0 | 对该意图没有帮助 |
对于 `E403 API rejects my request`,权限文档是 2 级。Token 过期文档是 1 级:它讨论的是另一种与访问有关的请求失败,但刷新 Token 并不能授予权限。这些标签是在检索之前根据测试文档的含义写下的,没有经过独立的人工复核。
nDCG 会给 1 级的相关材料一些分数,但相关的操作不一定能解决当前问题。因此我们还要检查第一个 2 级正确答案排在什么位置。
在自己的应用中,可以从支持工单和常见用户任务中挑选查询。把看似合理但不能解决问题的答案也放进测试,请熟悉业务的人审核标注,再把标注和查询一起纳入版本控制。
## 小型测试集与固定输入
下载包包含四条调试查询和八条留出查询。我们先用前四条检查查询流程,再评估后八条;没有为了提高留出分数而调整参数或改写测试数据。归档保存了最终输入和结果,但没有按时间记录整个准备过程。
两组查询都使用同样的 12 篇文档,其中一个错误码问题还以不同措辞出现在两组中。所以这八条留出查询能演示检查流程,却不能代表对全新主题的搜索效果。真正上线时,应维护更大且独立的评估集。
为了复现结果,示例固定了以下内容:
- Manticore **29.9.0**,固定到 Docker digest `sha256:461b419739a2bbbffb4be0b32db26c41d7b435bf7fd1fce95b414ca5ccbb3775`;
- 语料库、查询划分、完整的判定矩阵、表结构、查询设置和评估器的哈希值;
- 版本为 `751bff37182d3f1213fa05d7196b954e230abad9` 的 `Xenova/all-MiniLM-L6-v2`,其配置、分词器和 ONNX 模型都有 SHA-256 校验;
- 返回五条结果、融合窗口为 12、RRF 排名常数为 10、文本与向量权重为 2:1。
Manticore 使用固定模型在本地生成文档和查询的 embedding,不调用云端推理 API。第一次运行会从指定修订版本下载模型文件并验证哈希,随后以只读方式挂载。锁定修订版本能防止文件被悄悄替换,但不能保证下载链接永远可用;长期运行的 CI 最好保存经过验证的模型副本。
脚本还会读回 Manticore 实际保存的文档,并运行 `SHOW CREATE TABLE`。这样即使有人绕开测试文件直接改了索引,也能检测出来。
## 比较关键词、向量和混合搜索
`queries.json` 中的每条测试数据都保存完整的用户文本和单独的关键词输入。错误码查询在关键词检索中只使用标识符本身;其他查询使用查询中的词,并用 OR(`|`)连接。运行器直接读取这些准备好的输入,它自己不会提取标识符,也不会分词。语义搜索接收完整文本。两个检索分支都拿不到预期的文档 ID 或相关性等级。
混合路径通过[倒数排名融合(RRF)](https://manual.manticoresearch.com/Searching/Hybrid_search#Weighted-fusion-%28fusion_weights%29)合并两个排序列表,并使用显式别名:
```sql
SELECT id, title, hybrid_score() AS score
FROM article04_docs
WHERE MATCH('E403') AS text
AND knn(vec, 'E403 API rejects my request') AS semantic
LIMIT 5
OPTION fusion_method='rrf', rank_constant=10,
window_size=12, fusion_weights=(text=2, semantic=1);
```
作为对比,纯关键词查询使用带 `ranker=bm25` 的 `MATCH()`,纯向量查询使用不带 `MATCH()` 的 `knn()`。三种方法都按同一套标签评分。2:1 的权重只是本例的选择,并非通用建议。
下面是八条留出查询的结果。MRR@5 衡量第一个正确答案排得有多靠前;nDCG@5 还会给相关文档计分。下一节会解释这两个指标。
| 检索路径 | MRR@5 | nDCG@5 |
|---|---:|---:|
| 关键词 | 0.938 | 0.825 |
| 向量 | 0.844 | 0.922 |
| 混合基线 | 0.938 | 0.955 |
这次运行中,混合搜索的 nDCG 最高。保留三种检索方式的结果也方便排查问题:排序变化时,可以分辨是关键词、向量,还是融合步骤造成的。
## 如何评价排序
**MRR@5** 衡量第一个 2 级正确答案的位置。它出现在前五个结果时,该查询得分为 `1 / rank`,否则为零,然后对所有查询取平均。1 级结果不算正确答案。
**nDCG@5** 考虑前五个结果的整体排序。2 级文档比 1 级得到更多分数,排名越靠后,得分越低:
```text
DCG@5 = sum((2^grade - 1) / log2(rank + 1)), ranks 1 through 5
nDCG@5 = DCG@5 / ideal DCG@5
```
理想排序是把**语料库中所有已判定的文档**按等级排序,再取前五个,而不是根据某次搜索碰巧返回了哪些文档来计算。结果列表过短时,缺少的位置不给分。合法的空排序指标值为零;而这个 CI 测试脚本还会额外把引擎返回空结果当作明确的测试失败。
单元测试包含可手算的例子:如果 1 级文档排第一、2 级答案排第二,倒数排名就是 `0.5`,nDCG 为 `(1 + 3/log2(3)) / (3 + 1/log2(3))`。测试还覆盖排名截断、重复或未知的 ID,以及相关却无法解答问题的文档。这有助于发现评估脚本自身的错误。
## 查询仍然成功,相关性检查却失败
现在把关键词检索从查询中去掉。Manticore 仍能执行查询并返回文档。示例通过 `--candidate` 从混合搜索切换到纯向量搜索,不会修改评估器,也不会伪造失败。
下面列出了全部八条留出查询,包括纯向量搜索表现更好的情况。RR 是第一个正确答案的倒数排名;nDCG 还考虑相关内容。
| 查询 / 意图 | 基线 RR@5 | 候选 RR@5 | 基线 nDCG@5 | 候选 nDCG@5 |
|---|---:|---:|---:|---:|
| h1: E401 request rejection | 1.000 | 1.000 | 0.945 | 0.945 |
| h2: E403 request rejection | 1.000 | 0.250 | 1.000 | 0.631 |
| h3: E507 snapshot failure | 1.000 | 1.000 | 1.000 | 1.000 |
| h4: E509 snapshot failure | 1.000 | 1.000 | 1.000 | 1.000 |
| h5: Recover a deleted document | 0.500 | 1.000 | 0.797 | 1.000 |
| h6: Keep erased content deleted after recovery | 1.000 | 0.500 | 0.933 | 0.797 |
| h7: Replace a schema while serving users | 1.000 | 1.000 | 0.964 | 1.000 |
| h8: Replace replication TLS credentials | 1.000 | 1.000 | 1.000 | 1.000 |
在 h2 中,正确的权限文档从第一位掉到第四位,候选版本把 Token 过期的步骤排在了第一位。在 h5 中,向量搜索反而改善了答案:基线错把永久删除排在了恢复前面。报告里两处变化都能看到;h5 的改善抵消不了 h2 的失败。
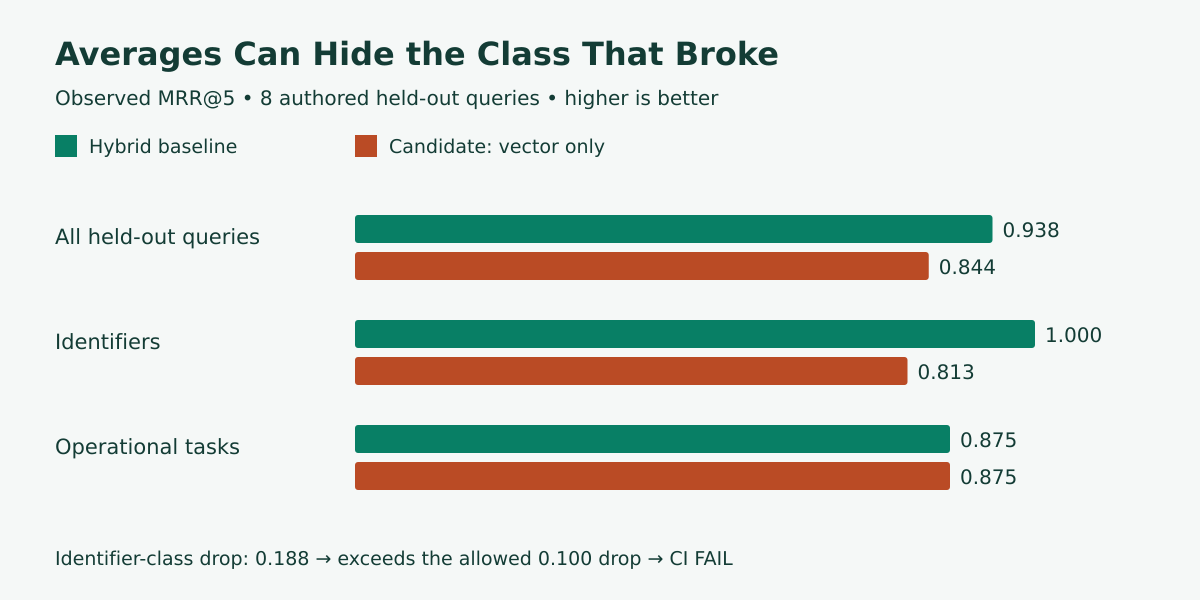
如果规定总体 MRR 允许下降 0.10,这个候选版本就会被放行:它只下降了 0.09375。标识符类下降了 0.1875。与此同时,任务类的平均值保持在 0.875,因为 h5 的改善抵消了 h6 的退步。任务类平均值不变,掩盖了两条查询朝相反方向变化。
示例有三条通过条件:单条查询的 nDCG 下降不得超过 0.20,查询类别的 MRR 下降不得超过 0.10,而且每个类别的 MRR 必须至少为 0.60。这些只是演示阈值,实际应用应根据错误的影响自行设置。纯向量版本有两项不通过:
```text
REGRESSION h2: nDCG@5 delta -0.369
REGRESSION identifier: MRR@5 delta -0.188
FAIL
```
相关性回归时脚本退出码为 1,配置、验证或引擎错误时退出码为 2;两者都会使 CI 失败。例如,把 `ARTICLE04_PORT` 指向关闭的端口,会看到 `ERROR: ` 和退出码 2。
## 在 CI 中运行示例
下载[可执行示例和已记录的运行证据](./search-relevance-ci/relevance-ci.zip),解压后进入 `relevance-ci/`。你需要 Python 3.10+、Docker Engine 和 Compose v2,没有 pip 依赖。请确认本机回环地址的 49418 端口空闲,或者把 `ARTICLE04_PORT` 设为另一个空闲端口。
```bash
sha256sum -c SHA256SUMS
bash reproduce.sh
```
`reproduce.sh` 会验证模型,启动限制为 2 CPU、3 GiB 内存的 `manticore-article04` Compose 项目,并加载示例表。它先检查基线,再运行纯向量版本,预期后者退出码为 1。只有基线通过且回归被检测到,演示才算成功。命令输出和报告都会保留。
要在真正会阻断流程的 CI 步骤中使用,请直接运行门禁:
```bash
# Passes for the unchanged baseline:
python3 run.py check --out runs/baseline-check
# Intentionally fails with exit 1:
python3 run.py check --candidate --out runs/candidate-check
```
每次 `check` 都会保存每条查询的文档 ID、指标和未经修改的引擎 HTTP 响应,旁边还有编号的 SQL 文件。请使用新的输出目录,避免覆盖旧报告。归档中的 `captured/` 保存了示例运行和负向测试。要使用 `ci-example.yaml`,请把它复制到项目的工作流目录。**示例故意运行失败的候选版本**;接入真实 CI 时请替换那条命令。
成本是在一台繁忙的共享 Linux 服务器(32 核)上测得的,其中只有引擎容器被限制为 2 个 CPU:模型文件已缓存时,每次 `check` 运行约需 0.4 秒(三次运行为 0.37 到 0.39 秒),引擎容器占用约 189 MiB 内存。首次运行会把约 87 MB 的模型文件下载到 `model-cache/`,所以请在 CI 运行之间保留这个目录,否则每次都要重新下载。
集成检查同样可以运行:
```bash
python3 integration_negatives.py
```
它们会拒绝缺失的查询或文档判定、重复的测试数据 ID、语料库或配置漂移、空结果、引擎错误,以及直接在引擎中修改的语料库或表结构。最后两项检查会短暂修改这张一次性的示例表,然后恢复;之后基线检查会再次通过。请只在这个隔离的实验项目中运行它们。
结束后:
```bash
docker compose down -v
```
这会删除本示例的容器、网络和数据卷,已下载的模型文件(约 87 MB)和报告仍保留在磁盘上。
## 何时更新参考排序
参考排序是针对一组固定数据和查询设置而审核通过的结果。CI 应与它比较,而不是自动重新生成。如果模型、表结构、文档、查询逻辑或标签发生变化,应先审核,再更新参考结果。
接受新的基线前,请逐条检查查询结果。如果某些排序退步是有意接受的,要写明原因。然后按 README 的说明保存新基线并更新锁定文件。只为让 CI 变绿而改基线,测试就失去了意义。
示例把查询构造器和评估代码放在同一个 `run.py` 文件中。`--candidate` 只能演示一种排序变化,不能直接支持任意查询代码修改;只更新 `inputs.lock.json` 仍会触发参考指纹检查失败。实际应用应把可变的查询代码与固定评估数据分开。脚本只接受 Manticore 29.9.0;升级时需要更新镜像、锁定文件并重新审核排序。
这是一个基于 12 篇虚构文档的小型 CI 测试,不是生产环境的性能或搜索质量基准。它不测试延迟、规模、生成答案或访问权限。近似检索和分数相同的结果可能因环境而异,因此检查允许小幅差异。同一台机器上的三次运行一致;我们没有测试其他硬件。
要在自己的应用中使用这套方法,先选出支持团队实际遇到过的查询,请领域专家审核正确答案,按错误代价设置阈值,并在接受总体平均分之前查看每条失败的查询。