
“世界变了。我能从水中感觉到,从大地中感觉到,也能从空气中嗅到。”
——凯兰崔尔,《指环王:护戒使者》
搜索也变了。过去很长一段时间,给商品目录做搜索,首先考虑的都是文字:怎么处理关键词、怎么容忍拼写错误、怎么给结果排序。这些问题现在依然存在。只不过,除了全文搜索,我们又有了向量搜索、混合搜索、图片搜索,以及能直接回答问题、而不只是列出一堆商品的 AI。
这些方法听起来都不错,直到你拿真实的搜索词试一试。比如有人搜索 merino wool socks(美利奴羊毛袜),向量搜索倒是理解了“美利奴羊毛”,但给出的前四件商品却是裤子、夹克、另一条裤子和 T 恤。袜子直到第五名才出现。
所以,究竟哪种搜索更好?我们不想光靠嘴争论,干脆让它们面对同一份商品目录,看看各自会交出什么答卷。
于是,我们做了 Manticore Search Playground 。它有七个标签页:可以按关键词、语义、照片或地理位置搜索,可以并排比较结果,也可以直接向 AI 提问。每组搜索结果下面还会显示对应的 SQL,以及等效的 HTTP JSON API 请求。

这不只是一个摆着漂亮商品卡片的演示页面,而是一个开源的小应用
。你可以用 Docker Compose 在本地运行,看看里面到底是怎么实现的。全文、向量、混合和地理位置搜索共用一张商品表。搜索照片则另外用了一张表和一个向量化服务;AI 部分使用 CALL CHAT(Manticore 的一条 SQL 命令)。
下面我们会用具体的搜索词、一些出人意料的结果,以及相应的 SQL,逐个看看这些方法。文中的结果数量和耗时,来自 2026 年 9 月的公开版 Playground。商品目录、模型或应用更新后,数字可能会有所变化。
我们到底在比较什么?
我们从 Google 的 ConvApparel 数据集中取了 82,524 件商品。这个数据集围绕人们如何挑选服装展开,相关对话中的商品推荐包含名称、描述、属性和照片。
七个标签页使用的都是这些数据:Full-text、Vector、Hybrid、Image、Geo、Compare 和 Ask AI。每次搜索,Playground 都会同时展示 SQL 和 curl 命令,你可以拿到自己的 Manticore 实例上运行。
这有什么意义?因为我们经常看到有人用两个不同的数据集、两个不同的演示来比较搜索引擎。这里商品目录始终不变,改变的只有搜索方式,区别自然一目了然。
大多数搜索模式只需要下面这一张表:
CREATE TABLE convapparel_products (
    id bigint,
    item_id text,
    title text,
    description text,
    features text,
    image_url text,
    category string indexed attribute,
    source text,
    categories json,
    lat float,
    lon float,
    embedding_vector float_vector knn_type='hnsw' hnsw_similarity='COSINE'
        model_name='onnx-models/all-MiniLM-L12-v2-onnx' from='title,description,features'
) min_infix_len='2'
如果你也打算用 Manticore 开发应用,有两个地方值得注意:
min_infix_len='2'允许从两个字符开始匹配单词的一部分,适合做搜索建议和自动补全。model_name配合from='title,description,features',就能启用自动生成向量(embeddings) 。添加商品时,Manticore 根据文本字段生成向量;按语义搜索时,又用同一个模型把查询转成向量。这一步不需要另起一个服务。
照片的处理方式有点不一样,后面再说。
1. 全文搜索:两个拼写错误,零条结果
先从熟悉的全文搜索说起。假设顾客想输入 leather jacket(皮夹克),却不小心打成了 lether jaket 。两个单词,两个拼写错误。对于网店来说,再正常不过了。
关掉 Typo tolerance(拼写容错),Playground 一件商品也找不到。

再把拼写容错打开,结果突然变成了 1,027 件商品。排在最前面的正是皮夹克,和我们预想的一样。

启用拼写容错时,执行的是这条查询:
SELECT id, title, description, features, category, image_url, weight() AS text_score
FROM convapparel_products
WHERE MATCH('lether jaket')
LIMIT 12
OPTION fuzzy=1
FACET categories ORDER BY COUNT(*) DESC
这里发生了什么?MATCH() 负责搜索文本字段,weight() 给出相关性评分。默认排序算法是 proximity_bm25,既考虑 BM25,也考虑词语之间的距离。
不过,这个例子的关键是 OPTION fuzzy=1
。它能让搜索匹配拼写相近的单词。去掉它:零条结果。加回来:皮夹克就出现了。
如果你准备在自己的应用里加入拼写容错,有两个用户体验方面的细节值得注意。
- 告诉用户,你修改了他的搜索词。 Playground 会调用
CALL QSUGGEST,并显示 Showing results for leather jacket(显示 leather jacket 的搜索结果)。如果有一天搜索引擎猜错了,用户至少知道这些奇怪的结果从何而来。 - 开启拼写容错时,别指望用户会写完整的 Manticore 全文搜索表达式。 大家输入的通常只是普通短语,不是精心构造的
MATCH()表达式。在模糊搜索模式下,运算符字符会被转义(用于短语搜索的引号除外)。
明明找到 1,027 件商品,分类数量加起来却有 1,127 件。怎么回事?
注意 SQL 最后的 FACET categories。除了返回商品,它还会返回各分类的结果数量
。这次搜索得到的是:
Outerwear — 960、Footwear — 58、Tops — 55、Bottoms — 54。
把它们加起来是 1,127,可搜索结果明明只有 1,027 件。

别急,不是加法算错了。一件商品可以属于多个分类,所以它可能在分类统计中出现好几次,但在商品总数里只算一次。
我们是这样处理的:
- 把分类存成 JSON 数组。例如,一件商品可以同时属于
["outerwear", "tops"]。 - 用
categories IN ('outerwear', 'tops')筛选。只要属于所选分类中的任意一个,商品就符合条件。 - 用单独的
COUNT(*)统计商品总数,而不是把各个 facet 的数量相加,避免重复计算。
为什么输入 int 时,自动补全不应该推荐 print
还有一种大家都很熟悉的功能:搜索框里的输入提示。配置得不好,它很快就会让人烦躁。
打开 Full-text
标签页,关闭 Search as you type(否则搜索结果会盖住提示),然后输入 linen sh。单词还没打完,就会出现 linen shirt、linen shoes 和 linen shorts。

实现它只需要一条查询:
CALL AUTOCOMPLETE('linen sh', 'convapparel_products', 0 AS fuzziness, 1 AS append, 0 AS prepend)
但这些参数可不是随便填的。
- 把完整输入交给 Manticore。 比如
linen sh,CALL AUTOCOMPLETE会保留前面的linen,只补全最后的sh。返回的每一条结果都可以直接用作搜索建议。 - 不匹配单词中间的部分。 设置
0 AS prepend,就不会在查询左边加*。否则输入int时可能出现print。从技术上说确实匹配,但一个刚开始打字的人,多半不是想找这个。 - 不在补全建议里改正拼写错误。
0 AS fuzziness表示只补全用户实际输入的内容。拼写纠错留到正式搜索时处理,而且会明确告诉用户改了什么。
CALL AUTOCOMPLETE
的全部参数都可以在文档中查到。
2. 向量搜索:不知道商品叫什么,也能找到想要的东西
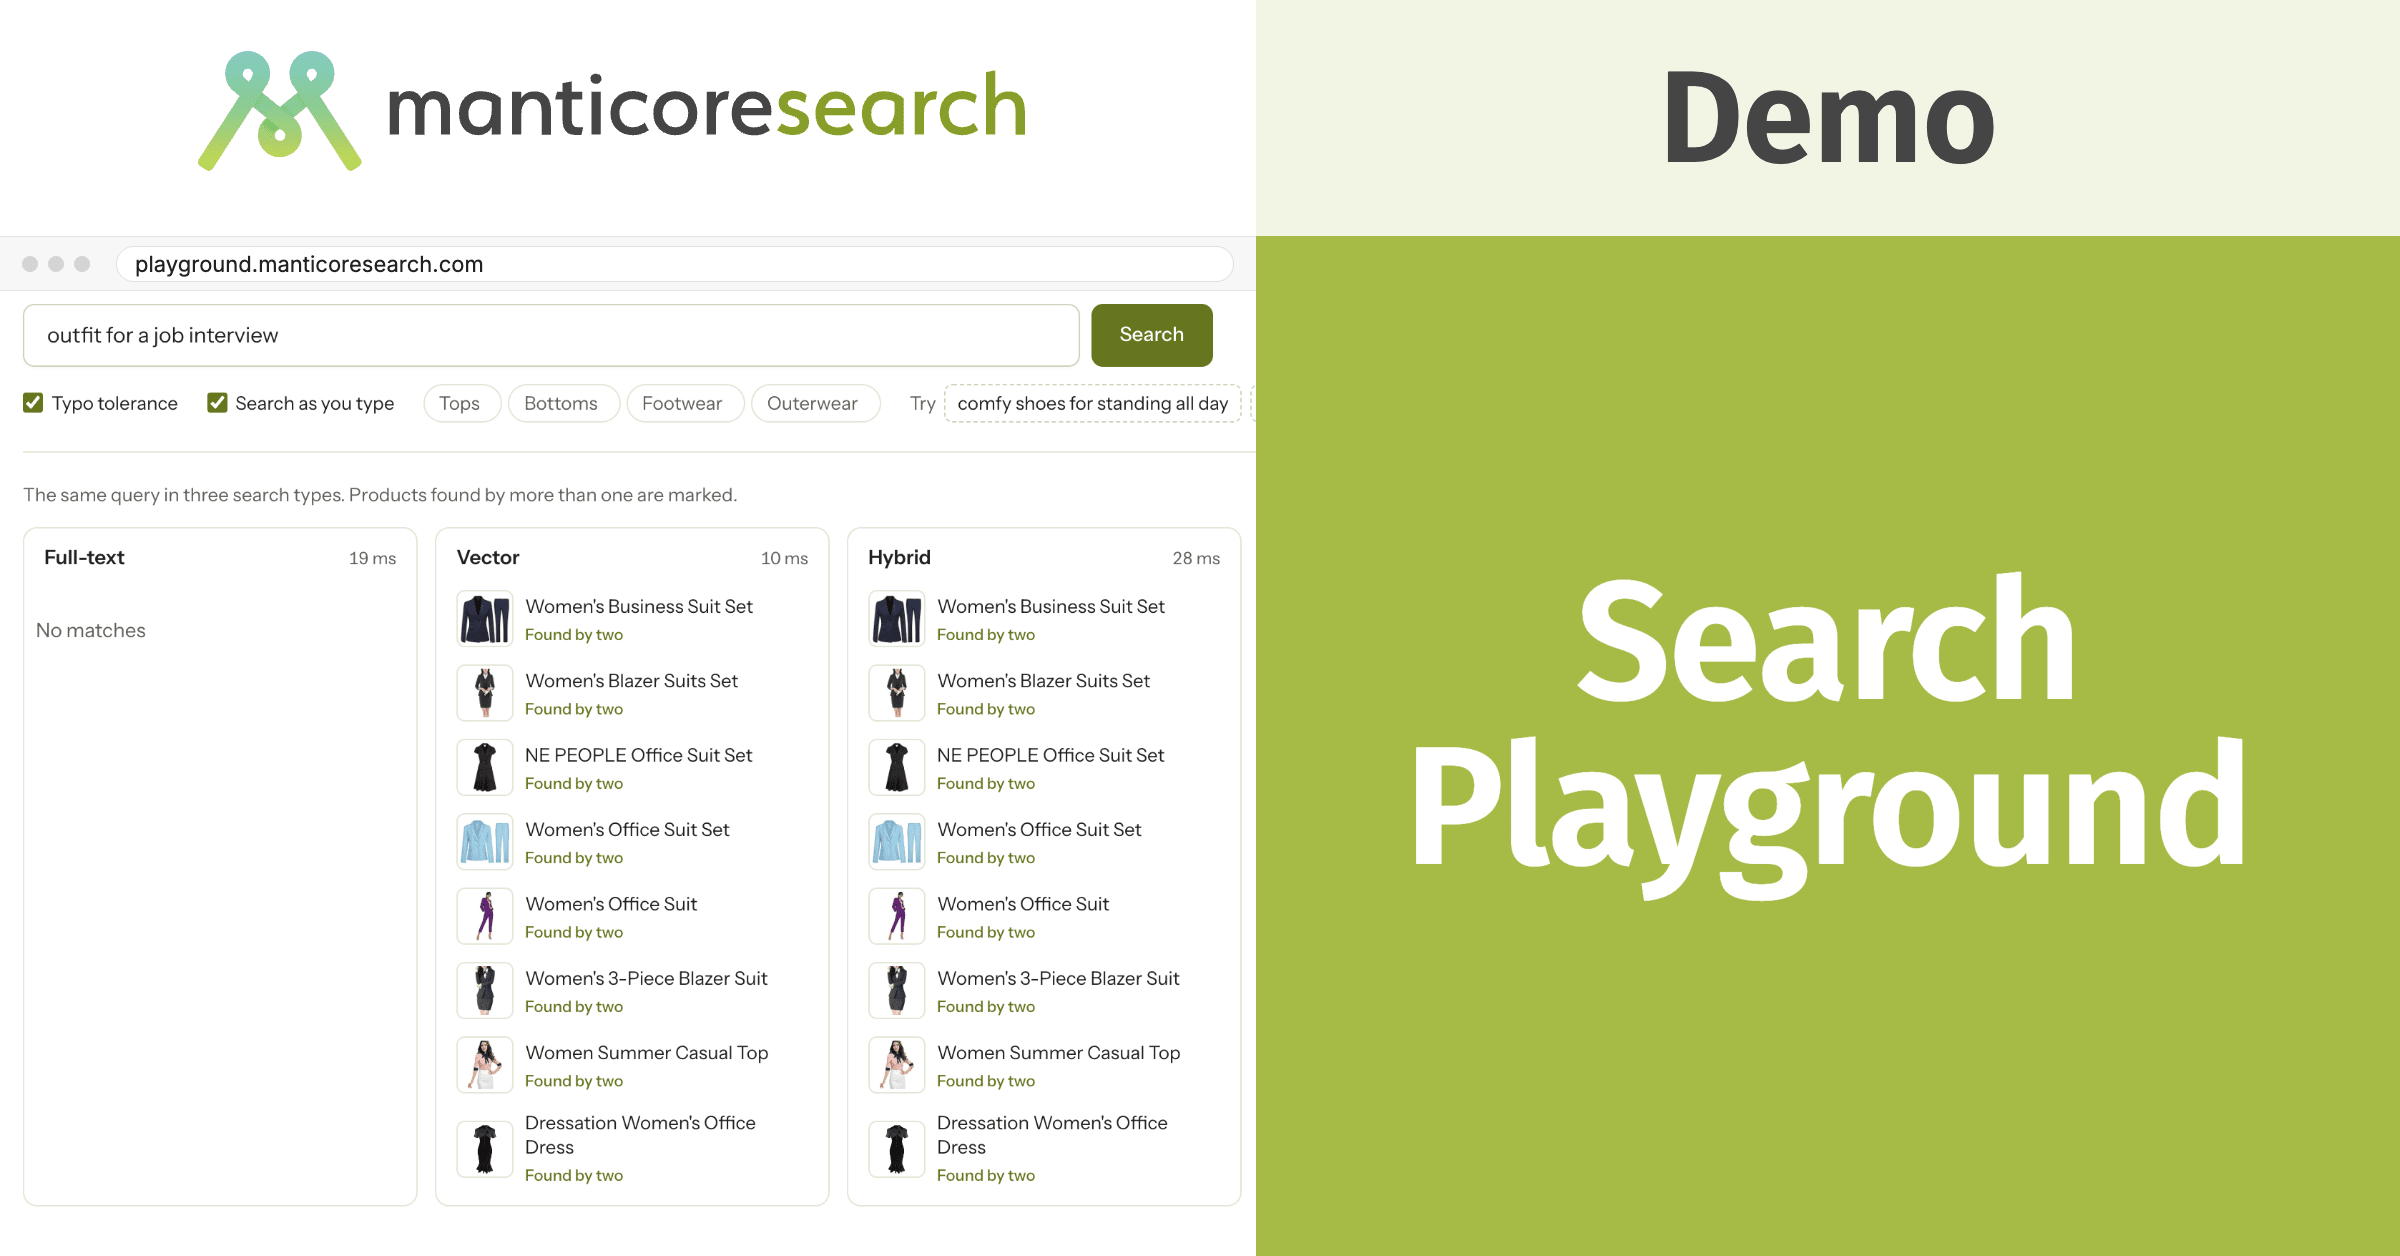
接下来换一种问题,也换一种搜索方式。有人没输入具体商品名,而是描述了自己的用途:outfit for a job interview ,也就是想找一套面试穿的衣服。
全文搜索在这里就有点吃力。默认情况下,它用 AND 连接各个单词(当然可以调整,但这里用的是默认设置),而目录里没有商品同时包含 outfit、job 和 interview。所以结果是 零条。
可切到 Vector 标签页,就出现了商务套装和搭配西装外套的服装。明明用户根本没输入 business suit 或 blazer。
SELECT id, title, description, features, category, image_url, knn_dist() AS distance
FROM convapparel_products
WHERE knn(embedding_vector, 100, 'outfit for a job interview')
LIMIT 12
注意,SQL 里没有预先算好的向量,传进去的就是普通文本。Manticore 使用和处理商品时相同的模型,把查询转成向量,再通过 HNSW 索引 找出最近邻。模型能够把这个问题和 business suit、office、blazer 等商品描述联系起来。
有时候,它甚至能顺手应付拼写错误。例如搜索 warm waterprof jacket ,依然能找到防水夹克,虽然我们并没有专门开启拼写纠错。
听起来挺完美,对吧?可别忘了开头那双袜子。
搜索 merino wool socks 时,前四个结果是美利奴羊毛裤、夹克、另一条裤子和 T 恤。袜子排第五。
向量搜索抓住了 merino wool,却没给 socks 足够的权重。颜色、尺码或者具体商品类型也可能遭遇同样的问题:语义上挺接近,找到的却不是你想买的东西。
3. 混合搜索:关键词和语义都能用,为什么非要二选一?
看完袜子的例子,一个很自然的问题就来了:为什么不把两种方法结合起来?

这就是混合搜索做的事。打开 Hybrid 标签页里的 merino wool socks 。这次袜子排在第一位,后面才是其他美利奴羊毛商品。
对应的 SQL:
SELECT id, title, description, features, category, image_url,
    weight() AS text_score, knn_dist() AS distance
FROM convapparel_products
WHERE MATCH('merino wool socks')
  AND knn(embedding_vector, 100, 'merino wool socks')
LIMIT 12
OPTION fuzzy=1, fusion_method='rrf'
Manticore 分别执行全文搜索和向量搜索,再通过 Reciprocal Rank Fusion(RRF,倒数排名融合) 合并结果。简单说,就是看商品在两个列表中分别排第几。如果两边都排得靠前,它在最终结果中的位置通常也会更高。
界面上也能看到这一点:商品卡片会标注 Words、Meaning 或 Words + meaning,告诉你是哪种搜索方式找到了它。
如果两部分用的是同一段查询文本,还可以写得更短:hybrid_match()
。它会完成全文搜索、将查询转换成向量、执行 KNN 搜索,再用 RRF 合并结果。
再看一个例子:bicycle shoes
(骑行鞋)。MTB 骑行鞋和 Unisex Bike Shoes,全文搜索和向量搜索都能找到;向量搜索还会找出根本没提到 bicycle 的 Cycling Shoes。但关键词有时也会把结果带偏:排在最前面的竟然是 Paul Parkman 的经典牛津皮鞋。它们的鞋头款式叫 bicycle toe,因此在全文搜索里排名靠前,向量搜索也找到了它们。
至于 warm waterprof jacket ,全文搜索负责纠正拼写,向量搜索则帮忙找到保暖又防水的夹克。两种方法都有用,只是各有所长。
Compare:把三组搜索结果并排看
为了不用在标签页之间来回切换,我们做了 Compare。它会分别运行 Full-text、Vector 和 Hybrid,把三组结果摆在相邻的列里。
如果同一件商品出现在多组结果中,Playground 会做标记。鼠标悬停在一张商品卡片上,其他列中相同的商品也会高亮。有时候,全文搜索和向量搜索还真能认出同一件东西:

但它们意见不一致的时候更有意思。
试试 outfit for a job interview :左边的全文搜索一片空白,向量搜索和混合搜索却给出了商务套装与西装外套搭配。

再试试 merino wool socks :全文搜索找到了袜子;向量搜索却被裤子和夹克吸引走了;混合搜索则把袜子放回第一位。

要真正比较这些方法,最好拿你自己用户输入过的搜索词来试,而不是只用我们编的例子。想先随便体验一下,可以从 bicycle shoes 、lether jaket 或 steel toe boots 开始。
相似商品:连搜索词都不用输入
假设有人正在看一件皮夹克,想再找几件类似的。总不能让他重新去搜索框里打字吧。
因此,Playground 的商品卡片里有两个区域:Similar by description 和 Similar by photo。

按描述找相似商品,执行的是这条 SQL:
SELECT id, title, description, features, category, image_url, knn_dist() AS distance
FROM convapparel_products
WHERE knn(embedding_vector, 8, 2388085963546244483)
LIMIT 8
这里 knn() 里的数字是商品 ID
,不是向量。Manticore 会找到这件商品已保存的向量,再搜索它的最近邻。应用不必先从数据库取出向量,然后又原封不动地发回去。
查找相似照片也是同一个原理,只是图片向量放在另一张表里。
4. 以图搜图
你试过在商品页面里描述一件具体的格子衬衫吗?名称和参数也许能告诉你面料、尺码,却不一定能说清格子的样式和颜色深浅。有时候,直接看照片更省事。
在 Image 标签页,你可以输入 red plaid flannel shirt (红色格纹法兰绒衬衫),也可以上传、拖入或粘贴一张图片,让系统帮你找类似的东西。

在这个演示中,我们用专门的模型把文字和照片转换成可以相互比较的向量。这样,“红色格子衬衫”的文字描述和一张相应的照片,在向量搜索所使用的多维空间里就会彼此靠近。
与文本向量搜索不同,图片搜索用的是独立的向量化服务。首先,服务把查询转换成向量。在公开版 Playground 中,这一步通常需要 50–250 毫秒,页面上会显示 turned into a vector in … ms。随后,Manticore 找到最近的图片向量,再去主商品表取出对应的商品。
SELECT id, knn_dist() AS distance
FROM convapparel_product_images
WHERE knn(image_vector, 100, (-0.0021, -0.01, 0.0782, …))
LIMIT 100;

SELECT id, title, description, features, category, image_url
FROM convapparel_products
WHERE id IN (3698494869106650404, 3557146672156430291, 1902002584948931003, …)
LIMIT 100
为了方便阅读,这里省略了部分 SQL。真正执行时,查询会包含向量的全部 512 个数值,以及 100 个商品 ID。
实现过程中,我们做了两个选择,或许也能给你的应用一些参考:
- 图片搜索与主商品目录分开管理。 文本使用 MiniLM,照片使用 Fashion CLIP。我们把图片向量存放在单独的表中,这样以后换模型或者重新计算全部图片向量,都不必改动商品本身,也不会影响文本搜索。
- 不索引反复出现的占位图片。 如果你抓取过商品目录,大概见过那张到处出现的 No image available。它出现一千次,也没法告诉你商品长什么样,索引它没有意义。所以在我们的演示中,82,524 件商品里约有 0.3% 没有图片向量。
5. 地理位置搜索:把商品放到地图上
做地理位置搜索时,我们遇到一个小问题:ConvApparel 没有坐标。为了展示地理搜索是如何工作的,我们给商品安排了纽约周边的模拟位置。
打开 Geo 标签页,就可以在地图上拖动位置、调整搜索半径,并立即看到 SQL 如何变化。
SELECT id, title, description, features, category, image_url, lat, lon,
    GEODIST(40.712800, -74.006000, lat, lon, {in=degrees, out=km}) AS distance_km
FROM convapparel_products
WHERE distance_km <= 10
ORDER BY id ASC
LIMIT 100
GEODIST()
用来计算距离。你可以在 SELECT 中返回这个值,用它筛选结果,也可以按距离排序。
在我们的演示里,结果按 id 排序,以便在地图选定的区域内展示分散的点。如果是真正的“给我看看最近的门店”,那多半应该改用 ORDER BY distance_km ASC,让距离最近的地点排在前面。
6. AI 搜索:良言无价
如果顾客连筛选条件和商品列表都不想研究,只想直接得到建议呢?比如他问:What should I wear to a summer wedding on the beach? (夏天去海边参加婚礼,应该穿什么?)
在 Ask AI 标签页,他可以直接提问,得到一个基于商品目录内容的回答。

Manticore 为此提供了 CALL CHAT:
CALL CHAT('What should I wear to a summer wedding on the beach?',
    'convapparel_products', 'shopping_assistant', '', 'embedding_vector')
CALL CHAT
可以结合商品表和向量索引工作。收到新问题后,系统可以先搜索相关商品,再把商品信息交给语言模型。这里用到的是 title、description 和 features 字段。Playground 还会在回答里附上对应商品卡片的链接。
而且可以接着聊。比如先问 I need warm boots for walking the dog in snow(下雪天遛狗,需要一双保暖的靴子),再问 Which of those are waterproof?(这些里面哪些防水?)。前文的对话上下文会保留下来,你不用再解释一遍自己说的是哪双靴子。
不过,有两点值得记住:
- 把 AI 推荐的商品展示出来。 如果 AI 信心满满地推荐一条“透气的连衣裙”,至少应该让用户点开商品页面,确认描述里是不是真的这么写的。
- 别指望语言模型能弥补所有搜索失误。 合适的商品得先被搜索出来,进入上下文。如果前一步没找到它,AI 就很难在推荐中可靠地考虑这件商品。因此,模型的质量和全文搜索的配置也很重要。
还有速度问题。公开版 Playground 通常需要 5–15 秒 才能给出 AI 回答。影响速度的因素不少,尤其是所选 LLM 模型、模型服务商,或者你本地运行时使用的硬件(Manticore 也支持这种部署方式)。关于如何配置聊天功能、如何评估搜索质量,我们在另一篇文章 里详细介绍过。
如果我想用 HTTP API,而不是 SQL 呢?
Manticore 会说两种“语言”:SQL 和 JSON。上面我们已经看了很多 SQL 示例;如果你更喜欢通过 HTTP 发送 JSON,演示里每条 SQL 旁边也有对应的 curl 命令。它通过 HTTP JSON API
执行同样的搜索。
例如,前面那个带拼写错误的查询,对应的请求是:
curl -X POST localhost:9308/search \
  -H 'Content-Type: application/json' \
  -d '{
  "table": "convapparel_products",
  "query": {"query_string": "lether jaket"},
  "options": {"fuzzy": true},
  "limit": 12,
  "_source": ["title", "description", "features", "category", "image_url"],
  "aggs": {"categories": {"terms": {"field": "categories"}, "sort": [{"count(*)": {"order": "desc"}}]}}
}'
只要 Manticore 里已经加载了这张表,它就会返回相同的商品和分类统计。
说到全文搜索默认怎么连接单词,这里还有个容易忽略的区别:query_string 和 SQL MATCH() 一样,默认用 AND 连接单词;但 JSON 的 match 查询默认用的是 OR。把查询从一种格式改写成另一种时,别忘了这点。
整套 Playground 都可以在本地运行
Playground 的代码在 GitHub 上 。要在本地运行,只需要 Docker Compose:
git clone https://github.com/manticoresoftware/demo-search-playground
cd demo-search-playground
cp .env.example .env
./scripts/init_manticore.sh
docker compose up --build app embed
启动后打开 http://127.0.0.1:8000 。
仓库已经包含提前计算好的商品向量,因此部署时不必重新生成。想试试 Ask AI,启动前需要在 .env 文件的 OPENROUTER_API_KEY 中填入 OpenRouter 密钥。其他标签页不需要密钥。
首次启动时,图片向量化服务会下载一个约 600 MB 的 Fashion CLIP 模型。下载期间,其他搜索功能照样能用。想自己执行页面上的 SQL,也可以用 docker compose exec manticore mysql。
Playground 速查表:从哪里开始试?
| 功能 | Manticore 中对应的功能 | 试一试 |
|---|---|---|
| 按相关性排序的全文搜索 | MATCH()、weight() | levis 501 |
| 拼写容错 | OPTION fuzzy=1、CALL QSUGGEST | lether jaket |
| 按分类统计 | FACET | lether jaket |
| 自动补全 | CALL AUTOCOMPLETE | 在 Full-text 标签页输入 linen sh |
| 自动生成向量的向量搜索 | 使用文本查询的 knn() | outfit for a job interview |
| 混合搜索 | MATCH() + knn()、fusion_method='rrf' | merino wool socks |
| 相似商品 | 使用文档 ID 的 knn() | 打开任意一件商品 |
| 图片搜索 | 对照片向量执行 knn() | red plaid flannel shirt 或上传照片 |
| 地理位置搜索 | GEODIST() | Geo 标签页 |
| AI 搜索 | CALL CHAT | summer wedding on the beach |
| JSON API | /search 接口 | 任意一组结果下方的 curl 命令 |
公开版 Playground 运行在一台配置不高的服务器上。除 AI 聊天之外,大多数查询耗时约 5–100 毫秒。
试过这些例子就会发现,没必要指望一种搜索方式解决所有问题。精确关键词很重要时,全文搜索表现不错;用户只会描述需求时,向量搜索派得上用场;混合搜索则把两者结合起来。照片和地理位置需要各自的搜索方式,而当用户想要的是直接回答、不是一长串商品时,AI 就能派上用场。
当然,这些例子还远远没展示出搜索可能犯的所有错误。肯定存在某个查询,能让全文搜索、向量搜索和混合搜索一起翻车。
你能想出这样的查询吗?

打开 Playground 试试看。如果发现特别糟糕的搜索结果,欢迎在 GitHub 提 issue ,或者到 Slack 告诉我们。如果你也想在自己的应用里实现类似的搜索,可以直接拿 Playground 的开源代码 作为起点。