
Manticore Search 同时支持行式和列式属性存储 。当工作集能放入内存时,行式存储表现很好;但当大型数据集超出 RAM 时,列式存储尤其有用:只需要少量属性的查询可以读取并缓存主要是它们实际使用的数据。
这两种布局之间曾有一个重要的性能差距。在 KNN 向量搜索 期间,Manticore 会使用原始全精度向量对 HNSW 候选项重新打分。在之前的列式访问路径下,这一步比行式存储慢得多。在我们的 DBpedia 基准测试中,行式存储提供了 2.80x–3.53x 的 KNN 吞吐量。
问题并不在列式布局本身。列式向量通过可复用缓冲区读取,这使 Manticore 无法为多个向量保留稳定指针,也无法批量处理它们。
我们将列式访问改为使用内存映射。这让向量拥有稳定地址,同时仍允许操作系统按需加载和逐出文件页。结果是 KNN 吞吐量提高了 2.57x–3.13x,达到行式性能的 85–92%,并且不牺牲列式存储在数据大于可用内存时仍能高效工作的能力。
从列式存储进行重评分会有多慢?
我们使用 DBpedia 数据集,在 16 核 AMD Ryzen 9 5950X 上测量了 KNN 吞吐量:
- 975,000 个向量
- 每个向量 1,536 个坐标
- 1-bit 量化
- 每次运行 5,000 个不同查询
- 可放入可用内存的工作集
- 默认的过采样和重评分行为
初始对比使用了行式和列式向量存储:
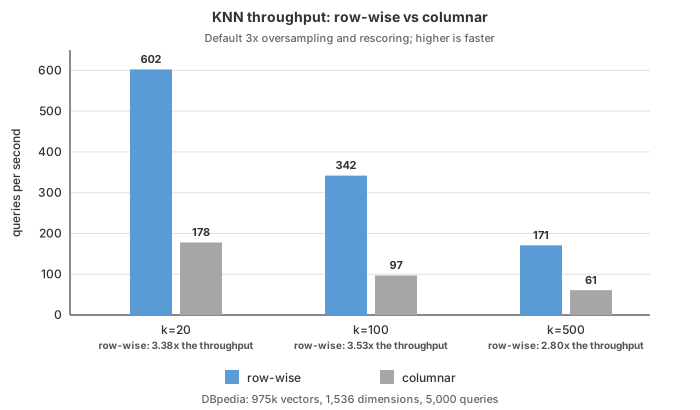
在三次测量中,行式路径提供了 2.80x - 3.53x 的吞吐量。
图遍历在两个结果中贡献相同。吞吐量差距来自重评分阶段。
为什么默认设置让这一点很重要
重评分和过采样是 Manticore 默认 KNN 行为的一部分:
oversampling=3.0会在 HNSW 搜索前放大请求的k,取回比最终查询需要更多的近似候选项。rescore=1会获取这些候选项的原始 32 位向量,重新计算距离,再次排序,并返回最终 topk。
因此,默认查询路径是:
requested k -> retrieve up to 3 x k candidates -> rescoring -> return k results
这会改变我们解读基准测试数值的方式:
| 请求的 k | 目标 HNSW 候选池 | 重评分后的最终结果 |
|---|---|---|
| 20 | 60 | 20 |
| 100 | 300 | 100 |
| 500 | 1,500 | 500 |
例如,k=500 会让 HNSW 搜索使用有效 k 1,500。这些候选项会进入精确重评分,最终返回最好的 500 个结果。过滤、磁盘块以及候选项可用性可能会影响实际物理读取次数,而目标候选池仍是请求结果数的三倍。
过采样和重打分 可以提升排序质量,尤其是在使用量化向量时。禁用它们会改变正常的质量/性能权衡。优化默认路径会直接惠及典型的 KNN 查询。
图搜索相同;向量访问不同
行式和列式 KNN 表使用相同的 HNSW 图搜索。在两种场景中,图都会在近似索引中导航并生成候选文档 ID。向量存储在这个阶段之后才变得相关:重评分需要每个候选项的原始全精度值。
行式访问器可以为每个驻留向量提供稳定地址。Manticore 可以保留多个向量指针,预取它们的数据,并一起计算多个距离。
列式访问的工作方式不同。它通过可复用读取缓冲区获取向量。后续读取可能覆盖该缓冲区,因此重评分代码只能先处理一个向量,再获取下一个,而不能保留一组指针进行批量处理。
随着向量维度升高以及用户增大 k,这种差异的代价会越来越高。该基准测试展示了有效候选池为 60、300 和 1,500 时的影响,但用户也可以请求其他 k 值,同样的机制仍然适用。
由于 HNSW 遍历相同,这种重评分行为解释了观察到的存储模式差距。
为什么列式存储仍然重要
列式存储最初面向的是没有足够内存加载某个查询属性全部数据的场景。它把同一个属性的所有值相邻排列。例如,读取 price 的一个页面时,其中大多是更多 price 值,而不是与类别、时间戳和其他属性交错在一起的价格。
行式存储会把一个文档的属性放在一起。当查询需要完整行时这很有用,但只读取一个属性的查询也可能把无关值带入内存。对于针对单个属性的扫描、过滤和聚合,这会降低每个已加载页面中的有效数据密度。
连续的列式布局通常在内存压力下表现更好,因为它读取和缓存的更多是请求的属性,而更少是无关数据。当表远大于 RAM 时,这一优势尤其重要。
性能下降的原因更简单:重评分期间的随机向量读取必须经过一个可复用缓冲区。
列式向量的新访问路径
内存映射文件的性能取决于工作负载;对于重打分,关键收益是能够稳定访问列式向量。
映射会为文件预留虚拟地址空间。进程访问页面时,物理页面会按需进入 RAM,操作系统也可以在内存压力下回收这些页面。因此,一个映射可以大于可用物理内存。
对于重评分,指针稳定性是关键变化。向量可以在映射区域中被直接寻址,而不是通过可复用读取缓冲区复制。于是 Manticore 可以:
- 按磁盘块和行 ID 对候选项排序,以改善局部性。
- 按批收集稳定的向量指针,每批最多 256 个候选项。
- 在需要之前预取向量数据。
- 为该批次计算距离,在支持的情况下成对处理,并单独处理任何剩余项。
内存映射启用了行式存储已经受益的批量重评分路径。
可放入内存的结果:大部分差距消失
我们使用内存映射列式访问重复了 DBpedia 测试,并比较了全部三种存储路径:
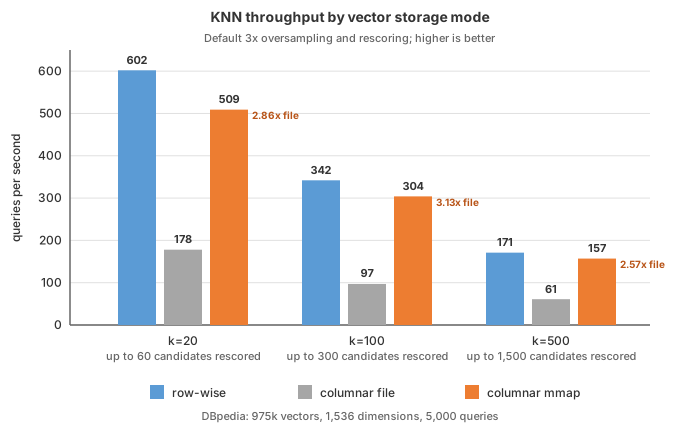
在 k=20 时,列式吞吐量从 178 QPS 提升到 509 QPS,即 file 结果的 2.86 倍。在 k=100 时,从 97 QPS 提升到 304 QPS,提升 3.13 倍。在 k=500 时,从 61 QPS 提升到 157 QPS,提升 2.57 倍。
列式 file 访问达到行式吞吐量的 28-36%。内存映射列式访问达到 85-92%。它相对于行式存储的剩余差距在 k=20 时为 15.4%,在 k=100 时为 11.1%,在 k=500 时为 8.2%。
随着 k 以及由此产生的重评分工作量增加,批处理变得更有价值,这与差距缩小的趋势一致。在基准测试的 k=500 点上,内存映射列式存储的性能与行式性能相差约 8%,而不是只能提供大约三分之一的吞吐量。
这确定了驻留工作集下的结果。下一个问题是,新路径在列式存储原本面向的内存受限条件下表现如何。
外部存储结果:taxi 基准测试
对于通用搜索,我们在同一台 Ryzen 9 5950X 上使用了一个大得多的 taxi 数据集:
- 17.4 亿个文档
- 32 个磁盘块
- 表总大小 372 GB
- 被查询的
.spc列式存储文件 88 GB - Docker 内存限制 32 GB
被查询的列式数据占用是容器全部内存限制的 2.75 倍。搜索服务器还需要为自身数据结构使用内存,留给文件系统支持页面的空间少于 32 GB。这是一个外部存储工作负载,因此查询会在页面逐出和物理 I/O 下运行。
我们针对两个版本的数据运行了相同的通用搜索套件:
- taxi: 完整的 17.4 亿文档表,超过可用内存。
- taxi1: 一个磁盘块,其工作集可放入内存。
这 17 个查询包括全文搜索、无过滤聚合、等值和范围过滤、索引查找,以及高基数和低基数 GROUP BY 操作。这些也是我们在 db-benchmarks.com
的公开对比中使用的 taxi 查询。
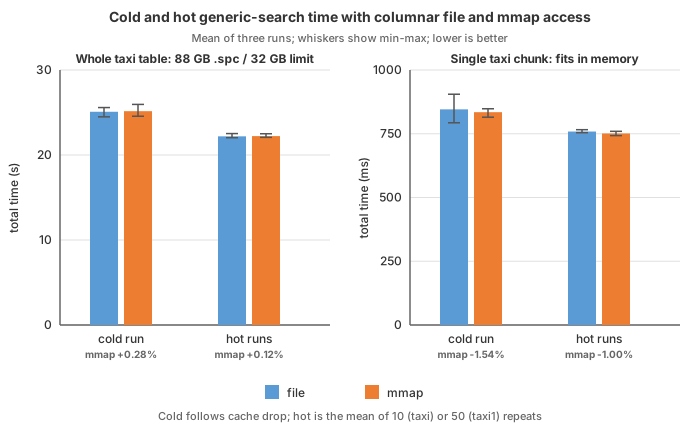
每种访问路径都进行了三次完整运行。下图使用这些运行中服务器报告时间的算术平均值,须线显示最小值和最大值。每个值代表整个 17 查询套件的总时间。
冷测量和热测量分开分析:
- 冷 是基准测试清缓存阶段中第一次被测量的执行。
- 热 是每个查询重复执行的平均值:taxi 上 10 次,taxi1 上 50 次。
冷运行
| 数据集 | 列式访问 | 平均值 | 最小-最大 | 相比 file 的变化 |
|---|---|---|---|---|
| 完整 taxi 表,外部存储 | file | 25.086 s | 24.489-25.581 s | - |
| 完整 taxi 表,外部存储 | mmap | 25.155 s | 24.561-25.952 s | +0.28% |
| 单个 taxi 块,驻留 | file | 845.667 ms | 793-905 ms | - |
| 单个 taxi 块,驻留 | mmap | 832.667 ms | 815-848 ms | -1.54% |
越低越好。
在完整 taxi 表上,mmap 在冷运行中慢了 0.28%,差异可以忽略不计。
在驻留的单个块上,mmap 快了 1.54%:832.667 毫秒对比 845.667 毫秒,这是一个小幅改进。
热运行
| 数据集 | 列式访问 | 平均值 | 最小-最大 | 相比 file 的变化 |
|---|---|---|---|---|
| 完整 taxi 表,外部存储 | file | 22.196 s | 22.033-22.521 s | - |
| 完整 taxi 表,外部存储 | mmap | 22.223 s | 22.074-22.500 s | +0.12% |
| 单个 taxi 块,驻留 | file | 758.667 ms | 754.120-765.920 ms | - |
| 单个 taxi 块,驻留 | mmap | 751.087 ms | 742.660-759.540 ms | -1.00% |
越低越好。
在外部存储表上,mmap 在热运行中慢了 0.12%,差异可以忽略不计。
在驻留块上,mmap 快了 1.00%:751.087 毫秒对比 758.667 毫秒。分组和范围查询有所改进,而一些简单聚合略微反向变化。各查询变化不一且总体差异很小,这再次支持二者性能接近。
综合冷运行和热运行可以看出,映射路径保留了非 KNN 搜索性能。当被查询的列式文件超过可用内存时,它表现中性;当一个块可放入内存时,它略快一些。
为什么非 KNN 的 mmap 性能仍然接近
KNN 的大幅改进来自重评分策略的改变:稳定的向量指针带来了更好的局部性、预取和批量距离计算。非 KNN taxi 查询不使用这条批量 KNN 重评分路径,因此不会从中受益。
在 Linux 上,普通读取和文件支持的 mmap 都会经过内核页缓存。file 模式会把缓存数据读入应用程序缓冲区。mmap 则通过进程地址空间暴露文件支持的页面,并通过缺页异常载入缺失页面。两条路径都受相同的物理内存限制、页面回收和后端存储约束。
这一共同基础有助于解释非 KNN 的性能接近。mmap 对指针和访问模型的改变足以解锁批量 KNN 重评分,而操作系统在两种访问模式下都会继续管理底层文件页面。
结论
重评分可能是默认 KNN 执行中的重要组成部分。三倍过采样意味着请求 500 个结果的查询会在重评分阶段之前使用有效 HNSW k 1,500。随着用户调高或调低 k,重评分工作负载也会随之变化。当候选向量通过列式 file 访问一次读取一个时,即使 HNSW 遍历本身没有变化,KNN 吞吐量仍比行式存储低 64-72%。
稳定的映射地址允许 Manticore 批量处理这项工作。在 DBpedia 上,列式吞吐量提高了 2.57-3.13 倍,并达到行式性能的 85-92%。
内存受限测试表明,这种方法也保留了列式存储原有的优势。在 32 GB 容器限制下查询 88 GB 列式数据时,非 KNN 搜索时间的变化仅为冷态 +0.28%、热态 +0.12%。常驻单块结果略有优势,冷态为 -1.54%,热态为 -1.00%。总体结果是:默认 KNN 重打分大幅改进,同时在两种内存条件下都保持了非 KNN 搜索性能基本持平。从 Manticore Search 29.9.0
开始,mmap 是列式存储的默认访问模式。
列式访问配置
access_columnar_attrs
选项控制列式文件的访问方式。其默认值为 mmap,因此不需要为每个表单独设置。也可以在创建表时显式选择该模式:
CREATE TABLE products (
    title TEXT,
    embedding FLOAT_VECTOR
        KNN_TYPE='hnsw'
        KNN_DIMS='1536'
) ENGINE='columnar'
  access_columnar_attrs='mmap';
之前的 file 模式仍然可用。要将其作为服务器范围的默认值,请把它添加到配置文件的 searchd 部分:
searchd {
    access_columnar_attrs = file
}
该选项会改变列式文件的访问方式。它们的存储格式和 KNN 查询语法保持不变。