Векторные базы данных в serverless-модели обычно обещают простую вещь: не требуется развёртывание и настройка, а провайдер берёт на себя управление хранилищем, масштабирование и обеспечение доступности. turbopuffer — один из лучших примеров этого класса: быстрый движок векторного поиска, использующий object storage в качестве хранилища, которым пользуются Cursor, Notion, Linear и другие.
Такой подход действительно снижает операционную нагрузку на команду, но он не бесплатен. Поэтому возникает закономерный вопрос: какая часть этих преимуществ нужна небольшому, чётко определённому сценарию, и во что обойдётся та же нагрузка на двух недорогих VPS с Manticore Search — по цене и по производительности?
Ответ на него дают цифры: в этом сравнении векторных баз данных обе системы тестируются в равных условиях на одном и том же наборе данных.
Нагрузка и конфигурация теста
Мы взяли нагрузку, типичную для стандартных сценариев (несколько запросов в секунду (QPS) и записей в секунду (WPS)), и конфигурация turbopuffer была выбрана под расчётную нагрузку:
| Параметр | Значение |
|---|---|
| Набор данных | DBpedia (эмбеддинги OpenAI) |
| Хранимые документы | 975 тысяч |
| Размерность векторов | 1536 (косинусное сходство) |
| Задержка turbopuffer (P50/P90/P99, warm namespace) | 14 / 17 / 27 мс |
| Расчётная стоимость turbopuffer | $75 / месяц (на июль 2026) |
В этой таблице метрики задержки приведены по данным вендора, а расчётная стоимость взята из публичных источников. Стоимость взята из калькулятора стоимости turbopuffer, а задержка — из опубликованного ориентира turbopuffer: конкретно P50/P90/P99 для warm namespace из внутреннего бенчмарка вендора:

На этом скриншоте важны два момента. Во-первых, эти 14/17/27 мс относятся к warm namespace; тот же бенчмарк показывает 874 / 1214 / 1686 мс для cold namespace. Если namespace вытеснен из кэша, первые запросы к нему выполняются примерно в 50-60 раз медленнее — прямое следствие многоуровневой архитектуры хранения у turbopuffer. Во-вторых, в бенчмарке turbopuffer используется другая нагрузка (1024 измерения, 10 млн документов), чем у нас (1536 измерений, 975 тысяч документов). Измеренные нами показатели задержки и пропускной способности turbopuffer на нашем наборе данных приведены ниже, и они отличаются от этих заявленных цифр. Наш набор данных — 975 тысяч документов (DBpedia); обе системы были загружены этими данными.
Эти $75/месяц взяты прямо из собственного калькулятора turbopuffer (см. ниже) для векторов размерности 1536 без атрибутов. Это соответствует параметру Attributes: None в тарифном калькуляторе и нашему бенчмарку: мы измеряли только векторный поиск (KNN), без хранимых атрибутов и без фильтрации по метаданным с обеих сторон. Оба движка поддерживают фильтрацию по атрибутам и полнотекстовый поиск (в Manticore есть ещё гибридный поиск ); мы просто не использовали это здесь, так что сравнение идёт только по KNN. Ценообразование зависит от использования, и важнее всего его структура:
| Компонент | Тариф | Для данной нагрузки | Стоимость |
|---|---|---|---|
| Хранение | ≤ $0.33 / GB | 1 млн документов (~3 GB) | $1.01 |
| Записи | ≤ $2.00 / GB | 10 млн записей, ~4 WPS (~61 GB) | $61.44 |
| Запросы | ≤ $1.00 / PB | 10 млн запросов, ~4 QPS (~13 PB) | $12.80 |
| Namespaces | н/д | 100 × 10K документов | Включены в тариф |
| Итого | $75 / месяц (минимум $16 по плану Launch) |

Основная часть суммы здесь почти целиком приходится на записи: тарифицируемый объём записанных данных — примерно 61 GB, что даёт $61.44 из $75, тогда как хранение (3 GB) — почти погрешность.
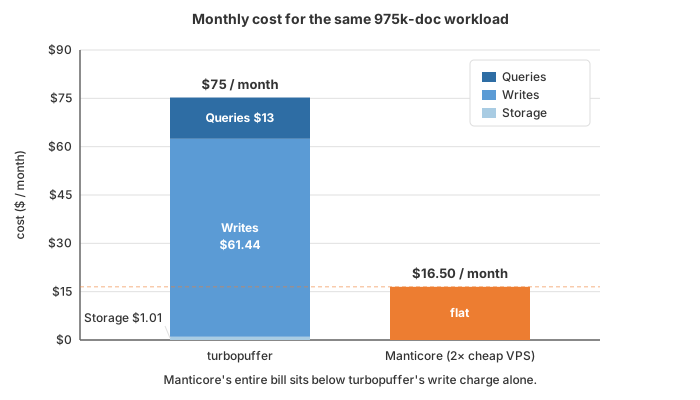
Значение ~13 PB в графе запросов на скриншоте калькулятора выглядит неожиданно высоким, но это расчётная единица биллинга, а не пропускная способность. turbopuffer тарифицирует запросы по объёму запрошенных данных (GB queried) с минимальным тарифицируемым объёмом — 1,28 GB на запрос, поэтому калькулятор просто считает 10M queries * 1.28 GB ≈ 13 PB. Фактический объём передаваемых данных на один запрос невелик (вектор запроса float32 размерности 1536 — это около 6 KB на входе, а ответ top-10 — несколько KB на выходе), но каждый запрос в таком маленьком namespace всё равно тарифицируется по минимальному объёму 1,28 GB. При ≤$1/PB все эти 13 PB стоят всего $13, так что доля стоимости запросов в общей сумме в этом сценарии незначительна.
Для нашего сравнения это важно: у векторной базы данных на собственных серверах таких счётчиков нет. Записи стоят только процессорного времени, у запросов нет минимального тарифицируемого объёма, а платы за гигабайты нет вовсе. (цены turbopuffer , журнал изменений цен )
Сравниваемые решения: Turbopuffer и Manticore
turbopuffer с точки зрения пользователя — serverless: хранилище живёт на S3/GCS/Azure object storage (~$0.02/GB), а горячие данные размещаются в кэше на NVMe и в оперативной памяти. Не требуется выделять серверные ресурсы, обновлять ОС, управлять репликацией или планировать ёмкость хранилища. Оплата взимается за объём хранимых данных, объём записи и объём запрошенных данных (в ГБ), а вычисление запросов выполняется на управляемой инфраструктуре turbopuffer, а не на вашем оборудовании.
Manticore Search — векторная база данных с открытым исходным кодом и поисковый движок, который вы запускаете сами. Для этого сравнения мы взяли самый недорогой реалистичный вариант, при котором сохраняется отказоустойчивость:
| Параметр | Значение |
|---|---|
| Узлы | 2 × Hetzner CX23 (регион eu-central) в кластере |
| Стоимость VPS | $8.25 / месяц |
| CPU на VPS | 2 ядра |
| Диск на VPS | 40 GB (данные таблицы занимают ~6 GB) |
| Роль второго узла | Реплика для отказоустойчивости |
| Общая стоимость Manticore | $16.50 / месяц (или $8.25 для одного узла, если отказоустойчивость не нужна) |
Manticore хранит векторы в индексе HNSW (через Manticore Columnar Library
) и поддерживает скалярную квантизацию (8-битную и 1-битную) с oversampling (выборкой расширенного набора кандидатов) и rescoring (повторной оценкой), позволяя выбирать баланс между расходом памяти, скоростью и полнотой поиска. Для этого теста мы использовали 1-битную (binary) квантизацию, oversampling=2.0 и rescoring, выбрав эти настройки специально так, чтобы достичь сопоставимого с turbopuffer уровня полноты, так что здесь задержка и пропускная способность сравниваются при одинаковом качестве.
Ключевые результаты: стоимость, качество, задержка, пропускная способность
| turbopuffer | Manticore (2× недорогие VPS) | |
|---|---|---|
| Ежемесячная стоимость | $75 | $16.50 (режим высокой доступности) / $8.25 (один узел) |
| recall@10 (5k запросов) | 0.9622 | 0.9663 |
| Сквозная задержка запроса P50 / P90 / P99 | 21 / 24 / 30 мс (включая сетевой round-trip) | 10 / 13 / 16 мс (локально, без сетевой задержки, после мерджинга чанков) |
| Предел пропускной способности на чтение (запросы) | ~300 QPS без батчинга (при concurrency=8, параллелизм — число одновременных соединений); с батчингом — до ~800–1,100 QPS | ~330 QPS (concurrency=2, без батчинга) |
| Устойчивая скорость массовой загрузки (write throughput) | ~1150 docs/s (массовая загрузка, bulk load) | 490-1100 docs/s (bulk load) |
| Операционная нагрузка | Нет (полностью управляемый сервис) | Вы самостоятельно развёртываете и администрируете |
На этой нагрузке стоимость Manticore на двух VPS по $8.25 ниже примерно в 4,5 раза; Manticore даёт сопоставимую с turbopuffer полноту поиска и после слияния чанков таблицы фактически показывает меньшую сквозную задержку (~10-13 мс против ~21 мс у turbopuffer в том же регионе), потому что локальный запрос обходится без сетевого round-trip, который у turbopuffer есть всегда. turbopuffer, в свою очередь, достигает более высокого предела пропускной способности запросов, но только с батчингом запросов (~800-1,100 QPS против ~330 на двух VPS с 2 ядрами); без батчинга с одной машины оба варианта сопоставимы (~300 QPS каждый). Для нагрузки в 4 QPS у обоих огромный запас пропускной способности. Компромисс Manticore — это отказ от «нулевого администрирования», и именно об этом остальная статья.
Полнота поиска (recall@10): сравнение результатов
Сравнивать задержку или стоимость бессмысленно, если обе системы не возвращают результаты сопоставимого качества. В тесте на наборе данных DBpedia (эмбеддинги OpenAI размерности 1536, cosine similarity, 975 тысяч документов) и 5,000 запросах:
| Система | recall@10 | |
|---|---|---|
| turbopuffer | 0.9622 | |
| Manticore | 0.9663 |
Разница составляет около 0.4 процентных пункта; она достаточно мала, чтобы остальное сравнение было корректным. В Manticore это получилось с помощью бинарной квантизации
+ oversampling=2.0 + rescoring: двоичное представление вектора в 32 раза меньше, чем float32, а rescoring пересчитывает финальные расстояния по векторам полной точности для лучших кандидатов.
Задержка (latency): сквозная задержка и влияние сетевого round-trip
Пользователю важен показатель, который он реально наблюдает: сквозная задержка, от отправки запроса до получения ответа. turbopuffer — удалённый сервис, так что сюда входит и сетевой round-trip до региона, где находится namespace. Измерения с машины в том же регионе, что и namespace: регион gcp-europe-west3 (в той же стране, что и хост запроса) показывают:
turbopuffer (тот же регион, сквозная задержка): P50=21ms P90=24ms P99=30ms
Запустите приложение дальше от региона — и задержка растёт вместе с расстоянием (легко 100+ мс между континентами), так что размещение рядом с сервисом действительно важно, и вы всегда платите как минимум за round-trip внутри региона.
turbopuffer также показывает два своих внутренних таймера: собственное время выполнения поиска (~12 мс), стабильное даже при высокой нагрузке, и общее время на своей стороне, включая запросы, которые ждут слот выполнения в очереди. Мы опираемся на них только для разбора результатов по пропускной способности ниже (время работы самого движка под нагрузкой остаётся низким), а не как на метрику задержки, потому что любое ожидание запроса — это реальная задержка, за которую вы платите. И ещё один момент сохраняет сравнение корректным: эти ~12 мс — это число, которое turbopuffer сам сообщает только для движка, без внутренней очереди. У Manticore тоже есть внутреннее профилирование запросов, но все цифры Manticore здесь — это сквозная задержка, уже включая любую внутреннюю очередь, если она есть. Поэтому во всём этом разделе мы сравниваем сквозную задержку со сквозной задержкой, а не engine-only у turbopuffer с полной задержкой у Manticore.
Задержка Manticore (в локальной среде, то есть сквозная задержка с пренебрежимо малым сетевым вкладом) под смешанной нагрузкой 4 QPS + 4 WPS (прогон на 10 минут) сильно зависит от того, до какого числа дисковых чанков таблица успела сжаться. Свежезагруженная real-time таблица разбита на много чанков; автооптимизация Manticore постепенно сливает их, и каждый KNN-запрос должен обойти каждый чанк, так что чем меньше чанков, тем быстрее запросы:
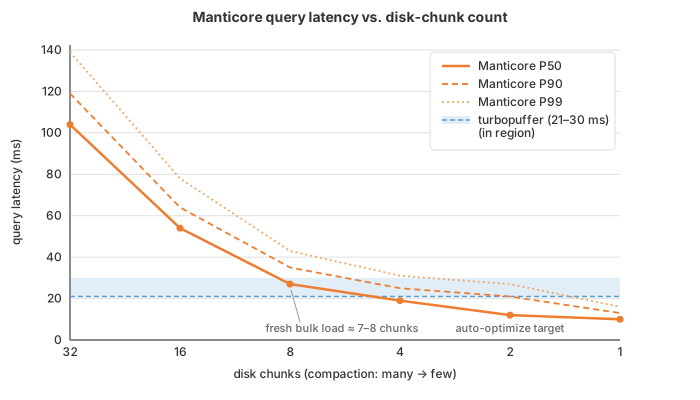
Состояния 32 / 16 / 8 / 4 чанка выше были получены намеренно, путём оптимизации до фиксированного числа чанков, чтобы построить кривую задержки. При реальной массовой загрузке результат заметно лучше: при нашем batch=1000 таблица стабилизировалась на 7 дисковых чанках (1 поток вставки) или 8 дисковых чанках (2 потока), так что свежезагруженная таблица оказывается примерно на уровне 8 чанков (~28 мс). Итоговое число — это, по сути, гонка между двумя процессами: вставки сбрасывают RAM-чанки на диск, а автоматическая оптимизация (auto-optimize) в фоне сливает эти дисковые чанки. Чем быстрее идёт заливка, тем быстрее новые дисковые чанки накапливаются, поэтому высокоскоростная загрузка (batch=1000) обгоняет фоновое слияние и оставляет больше чанков (7-8), а медленные построчные вставки (batch=1) создают чанки достаточно медленно, чтобы auto-optimize успевал, и таблица заканчивает всего на 3 чанках, но при гораздо более низкой скорости загрузки. То есть итоговое число чанков определяет именно скорость ingest, а не concurrency как таковая. После загрузки auto-optimize Manticore продолжает компакцию до 2 чанков (~13 мс в среднем).
Вывод: количество чанков — ключевой фактор, определяющий задержку. При 32 чанках Manticore работает примерно в 2-3 раза медленнее, чем ~21 мс сквозной задержки у turbopuffer. Но после автооптимизации до дефолтного нижнего порога в 2 чанка (~12-13 мс) он уже быстрее turbopuffer по сквозной задержке, а после компакции до одного чанка (~10 мс) — ещё быстрее, и всё это на железе за $8.25. Причина в основном структурная, а не в разнице скорости движка: оба выполняют основную часть поиска примерно за те же ~10-12 мс, но Manticore работает на ваших собственных VPS и может обслуживать запросы через localhost/LAN, так что мы не платим за сетевой round-trip, тогда как у turbopuffer всегда есть как минимум те самые ~9 мс в пределах региона. Разница в сквозной задержке — по сути это и есть сетевой round-trip.
Задержка чтения, то есть запросов, а не записи, зависит от степени компакции таблицы, а поддержание таблицы в компактном состоянии обеспечивается механизмами Manticore и не требует ручного вмешательства. Auto-optimize работает в фоне и сливает чанки до целевого уровня, который он автоматически поддерживает (в нашем случае таблица остановилась на 2 чанках). Этот целевой уровень — не ручная работа, а настройка: опция optimize_cutoff
(для таблицы через CREATE/ALTER или глобально в searchd) управляет этим, так что если вам нужна минимальная задержка, можно выставить optimize_cutoff=1, и фоновый оптимизатор будет держать таблицу на одном чанке без каких-либо ручных действий в стационарном режиме. Единственный реальный нюанс — во времени: сразу после большой массовой загрузки (bulk load) таблица ещё состоит из многих чанков, и запросы медленнее, пока auto-optimize не догонит. В нашем прогоне, при 8 чанках после загрузки с concurrency=2, фоновая автооптимизация сократила число чанков до 2 примерно за 15 минут, и в это время задержка запросов постепенно улучшалась. У turbopuffer вообще нет аналогичного этапа, и эта функциональность включена в тариф сервиса.
Пропускная способность чтения: без батчинга и с батчингом
Поскольку каждый запрос занимает примерно 12 мс времени движка плюс сетевой round-trip, одно соединение ограничено примерно 1 / (engine + round-trip) запросами в секунду, поэтому пропускную способность увеличивают за счёт одновременной отправки запросов, и цифры ниже для теста в том же регионе отражают именно это.
turbopuffer, тот же регион, обычные одиночные запросы (без батчинга). Добавление параллельных соединений поднимает пропускную способность, но только до определённого предела:
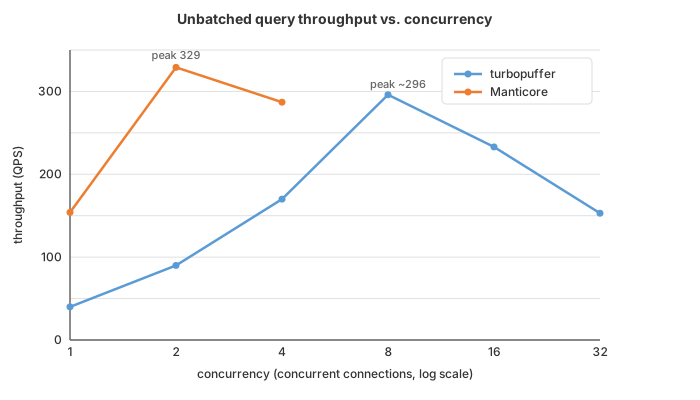
Пропускная способность чтения без батчинга достигает пика примерно на 8 соединениях (~296 QPS), а затем падает (233 QPS на 16, 153 на 32), тогда как сквозная задержка резко растёт (P90 33 → 108 → 423 мс на 8 → 16 → 32 соединениях). При этом собственное серверное время, которое показывает turbopuffer, остаётся стабильным на уровне ~12 мс. Поскольку это время не растёт, а сквозная задержка увеличивается, дополнительная задержка не попадает во внутренние таймеры turbopuffer: узким местом может выступать клиентская машина, сетевой путь или компоненты обработки вне таймеров сервиса, и этот бенчмарк не позволяет их различить. Зато он показывает, что простое увеличение concurrency без батчинга выше 8 не улучшило пропускную способность с той одной машины, на которой мы тестировали turbopuffer.
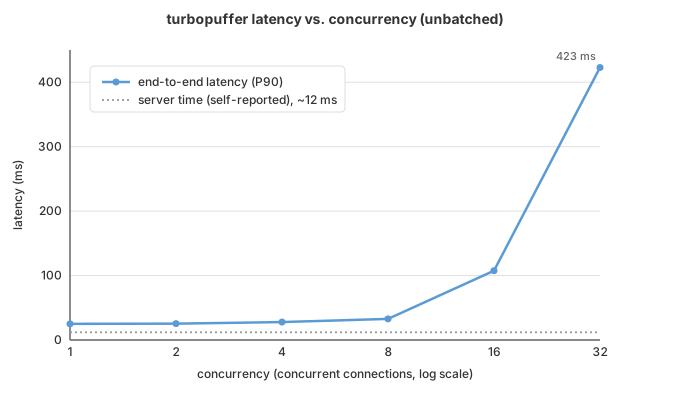
Поэтому мы считаем ~300 QPS наблюдаемым пределом пропускной способности без батчинга с этой одной машины, а не задокументированным лимитом сервиса turbopuffer. (Станет ли он выше на нескольких машинах, зависит от того, что именно становится узким местом — ресурс одной машины или общий путь; этого мы не тестировали.) Далеко за ~300 QPS эту же машину вывел уже батчинг запросов.
Батчинг запросов, когда несколько запросов упаковываются в один сетевой запрос, амортизирует сетевой round-trip и заметно поднимает пропускную способность; при этом чем выше QPS, тем заметнее хвостовые задержки:
- ~800 QPS без проблем: режим concurrency=4 / batch=8 давал 821 QPS при server-side time P50=15 / P90=20 / P99=29 мс.
- ~1,000-1,100 QPS с более высокими хвостовыми задержками: concurrency=8 / batch=8 дал 1,015 QPS, но P99 вырос до 58 мс; conc 4 / batch 16 достиг 1,105 QPS при P99=61 мс.
- ~1,170 QPS с перегрузкой: режим concurrency=8 / batch=16 давал 1,169 QPS, но общее время на запрос резко выросло (P99=455 мс, среднее ~70 мс), хотя серверное время поиска, которое показывает turbopuffer, всё ещё было только ~12 мс, то есть запросы ожидали в очереди на стороне сервиса сотни миллисекунд. Это неустойчивая рабочая точка.
Так что практический предел пропускной способности батчинга, который мы увидели на этом наборе данных, — примерно ~800 QPS без проблем и до ~1,100 QPS с более высокими хвостовыми задержками на стороне сервера; в любом случае это заметно выше, чем у двух VPS.
Однако у батчинга чтения есть три оговорки:
- Он помогает только если к вам одновременно приходит много независимых запросов, которые можно объединить в один пакет: поисковый backend с большим трафиком может так делать, а типичный путь «один пользователь, один запрос» — нет, так что для многих реальных приложений важна именно приведённая выше граница без батчинга (~300 QPS), а не показатель ~1,000+.
- Задержка одного запроса в батченном режиме — амортизированная, а не wall-clock. Если запросу приходится ждать заполнения батча, в его задержку входит и ожидание формирования батча, и собственная задержка запроса, так что пользовательская задержка при батчинге выше, чем кажется по усреднённой цифре.
- Батчинг чтения влечёт за собой дополнительную сложность на уровень приложения. Вам нужно собирать запросы, ненадолго удерживать их для формирования батча, раскладывать общий ответ по исходным вызовам, а также разбираться с частичными сбоями, что часто настолько неудобно, что этого просто не делают.
Manticore на двух VPS с 2 ядрами, после первоначальной загрузки, обслуживая запросы параллельно с приёмом 4 WPS записей (локально, так что без сетевого round-trip):
| Параллельных соединений | Запросов в секунду |
|---|---|
| 1 | 154 |
| 2 | 329 |
| 4 | 287 |
Manticore выходит примерно на 329 QPS при 2 соединениях; дальше вы начинаете перегружать 2 ядра, так что 4 соединения работают чуть медленнее. В отличие от снижения без батчинга у turbopuffer, это жёсткий предел: движок работает на 2 ядрах, и пробить этот предел можно, только добавив ядра или узлы, а это уже стоит дороже.
Эти цифры Manticore — без батчинга, в режиме «один запрос API на один сетевой вызов», то есть в том же формате, что и у вышеупомянутого прогона turbopuffer без батчинга. Батчинг не поднимет предел пропускной способности Manticore так, как он поднимает предел turbopuffer: батчинг помогает turbopuffer в основном тем, что амортизирует его ~9 мс сетевого round-trip на множество запросов, но у локального запроса Manticore нет такого round-trip, который можно было бы амортизировать, а реальное ограничение здесь — CPU на 2 ядрах, которое батчинг не снимает. Поэтому корректное сравнение — без батчинга против без батчинга, и здесь оба оказываются близко: turbopuffer ~296 QPS против Manticore ~329. Разница в том, что означает каждая цифра: ~329 у Manticore — это жёсткий предел для 2 ядер, а ~296 у turbopuffer — это просто предел, который показала наша одна машина. Добавление concurrency только ухудшало ситуацию, и локализовать причину мы не смогли (время движка, которое сообщает turbopuffer, оставалось стабильным, но это его собственная метрика, а не то, что этот бенчмарк может подтвердить). Так что ~300 — это практический предел без батчинга в нашей конфигурации, а проверенный путь выше него у turbopuffer — батчинг запросов (~800-1,100 QPS с той же машины); у Manticore это уже более мощное железо.
Так что по пропускной способности запросов чтения предел turbopuffer с батчингом (~800-1,100 QPS на управляемых вычислительных ресурсах turbopuffer) выше, чем у двух VPS с 2 ядрами (~330 QPS), а без батчинга оба варианта сопоставимы, и стоимость запросов turbopuffer невысока (вся стоимость запросов этой нагрузки составила около $13). Manticore масштабируется покупкой железа; turbopuffer масштабируется на инфраструктуре, которой вы не управляете. Нюанс в пользу Manticore: при низком concurrency Manticore на самом деле быстрее на одно соединение (154 QPS при 1 соединении против 40 у turbopuffer), потому что у локального запроса нет ~9 мс сетевого round-trip, за который приходится платить задержкой.
Но в рассматриваемом кейсе пропускная способность почти не важна. Цель — 4 QPS, и обе системы перекрывают её с огромным запасом: примерно 200-кратный запас пропускной способности у turbopuffer без роста хвостовых задержек и примерно 80-кратный запас по пропускной способности у Manticore. Пропускная способность становится решающим фактором только если вы ожидаете устойчивую нагрузку в сотни QPS, и тогда более высокий предел turbopuffer с батчингом — более безопасный выбор, а Manticore нужен больший (и более дорогой) кластер.
Что касается записи, обе системы оказываются ближе друг к другу:
- turbopuffer bulk load: 975 тысяч документов со скоростью около 1150 docs/s. Это наблюдаемая скорость загрузки; что именно ограничивает её (путь заливки, сеть или собственная индексация), извне сказать нельзя.
- Manticore bulk load (batch=1000): 750-1100 docs/s до сброса первого дискового чанка. Узким местом выступает этап построения HNSW-графа, ограниченный вычислительной мощностью (2 CPU-ядра), поскольку увеличение числа потоков вставки практически не повышает пропускную способность (451 → 490 docs/s с 1 → 2 потоков).
Загрузка данных (ingest): скорость и время bulk-load
Загрузка всего набора DBpedia в Manticore (975 тысяч документов, 1536 dim, построение графа HNSW) заняла:
| Concurrency | Batch | Скорость | Общее время |
|---|---|---|---|
| 1 | 1 | 365 docs/s | ~45 мин |
| 1 | 1000 | 451 docs/s | ~36 мин |
| 2 | 1000 | 490 docs/s | ~33 мин |
Для сравнения, turbopuffer загрузил те же данные со скоростью около 1150 docs/s, то есть примерно в 2.3 раза быстрее, чем Manticore на этих двух недорогих VPS. Это ожидаемо: turbopuffer строит индекс на своих более мощных управляемых вычислительных ресурсах, тогда как Manticore выполняет построение графа HNSW на 2 недорогих CPU-ядрах. Так что turbopuffer явно выигрывает по чистой скорости ingest, хотя для разовой первоначальной загрузки разница — это примерно 14 минут против ~33-36 минут, то есть это единовременные временные затраты, не влияющие на постоянную операционную нагрузку.
После начальной загрузки с batch=1000 таблица Manticore оставалась на 7 дисковых чанках (1 поток вставки) или 8 чанках (2 потока); увеличение числа потоков вставки на VPS с 2 ядрами не помогает. Итоговое число чанков определяется скоростью ingest, а не concurrency: вставки сбрасывают RAM-чанки на диск, а auto-optimize сливает их в фоне, так что чем быстрее идёт загрузка, тем сильнее фоновое слияние отстаёт. При высокой скорости загрузки (batch=1000) формируется 7-8 дисковых чанков, поскольку в фоне они не успевают сливаться; медленные построчные вставки (batch=1) создают чанки достаточно медленно, чтобы auto-optimize успевал, и запись заканчивается лишь на 3 чанках, но уже при более низкой скорости 365 docs/s вместо примерно 450-490. Дальше auto-optimize Manticore продолжает компакцию до 2 чанков (своей стандартной цели); если снизить optimize_cutoff до 1, он будет поддерживать один чанк, автоматически обеспечивая состояние с минимальной задержкой.
Хранение и ёмкость: объём данных и запас места
Объём данных таблицы Manticore в этом тесте — около 6 GB, а на каждом недорогом VPS доступно 40 GB диска, так что одного узла достаточно для хранения нескольких таких наборов — нет необходимости в тарифе с увеличенным диском. В turbopuffer хранение тарифицируется по ставке ≤$0.33/GB и для этого набора данных обошлось всего в $1.01, то есть действительно почти ничего. Как показывает разбор стоимости выше, основная разница не в стоимости хранения: $61.44 из $75 — это плата за объём записанных данных, которой у Manticore просто нет.
Компромиссы: что получаете и чем жертвуете
Цифры говорят в пользу Manticore по стоимости и по задержке, когда таблица сжата. Но сравнение — это не только цифры: за цену turbopuffer вы получаете то, чего не видно в таблице задержек.
Что вы теряете (выбирая самостоятельное размещение Manticore):
- Нулевое администрирование. У turbopuffer нет серверов, которые нужно патчить, нет реплики для переключения при сбое, нет диска, который нужно расширять. С Manticore это ваша задача (хотя само сжатие автоматическое, см. ниже).
- Эластичное масштабирование и более высокий предел пропускной способности. turbopuffer разделяет хранилище и вычислительные ресурсы и масштабирует их независимо; можно вырасти с 1M до 1B документов без смены архитектуры, а его управляемая инфраструктура с батчингом вышла примерно на ~800-1,100 QPS там, где две VPS с 2 ядрами упираются примерно в ~330. У двух VPS предел фиксированный: чтобы поднять его, нужно покупать больше железа.
- Модель scale-to-zero (оплата только за фактическое потребление, без фиксированных ресурсов). Для скачкообразных или очень маленьких нагрузок тарификация по использованию может оказаться дешевле даже фиксированных $16.50/месяц.
- Управляемый SLA (гарантии доступности, поддержка) на более дорогих тарифах.
Что вы получаете (с Manticore):
- Стоимость ниже примерно в 4,5 раза в рассматриваемом кейсе: фиксированный, предсказуемый счёт без платы за объём записываемых данных и без поштучного учёта запросов.
- Никакого сетевого round-trip. Запросы выполняются локально (через localhost/LAN), исключая сетевой round-trip, который удалённый сервис всегда добавляет к цене запроса (нижняя граница около ~9 мс даже при co-location, и больше между регионами), так что скомпактированная таблица быстрее по сквозной задержке.
- Полный контроль и локализация данных: данные размещаются в вашей инфраструктуре, плюс полнотекстовый поиск, фильтрация, гибридный поиск и SQL в одном движке.
- Безопасность и суверенитет данных: ваши векторы и исходные документы не покидают инфраструктуру, которой вы управляете, так что ничего не передаётся и не хранится у третьей стороны. Для команд с требованиями к локализации данных, GDPR или конфиденциальности это часто решающий фактор: вы сами отвечаете за шифрование, сетевую изоляцию и политику доступа, и вам не нужно проверять внешний сервис, доверять ему или учитывать его как дополнительную точку риска. В управляемом сервисе те же данные по определению находятся в облаке провайдера.
- Выделенные вычислительные ресурсы на собственных VPS: фиксированные, предсказуемые ресурсы, не разделяемые с другими арендаторами.
Выводы: когда выгоднее Turbopuffer, а когда — Manticore
Для большой, эластичной или всплесковой нагрузки, а также для команды, которая просто не хочет обслуживать базу данных, $75/месяц turbopuffer (и стоящая за этим управляемая serverless-модель) вполне оправданы.
Но для типичного случая с ограниченной нагрузкой (около 1M векторов, несколько запросов и записей в секунду), где команда готова поддерживать два сервера, две VPS по $8.25 с Manticore в качестве альтернативы turbopuffer дают ту же полноту поиска, сопоставимое время отклика после auto-optimize (и лучшее время отклика при компакции до одного чанка, без сетевого round-trip), достаточный запас пропускной способности в данном сценарии и счёт ниже примерно в 4,5 раза. Компромисс в том, что требуется самостоятельное развёртывание и мониторинг кластера, а если вам когда-нибудь понадобятся сотни QPS, управляемая инфраструктура turbopuffer масштабируется дальше двух фиксированных ядер.
Плата за serverless-модель — это плата за ценность управляемой инфраструктуры, а не просто наценка. Наш бенчмарк показывает, что для небольшой и предсказуемой нагрузки эта ценность востребована не в полном объёме: зачастую переплачивать до $75 в месяц нет смысла.