---
title: "Регрессионное тестирование релевантности поиска в CI"
description: "Поиск может работать без ошибок, но показывать неправильный ответ первым. На примере Manticore покажем, как ловить такие проблемы в CI."
date: 2026-11-13
author: "Dmitrii Kuzmenkov"
image: https://manticoresearch.com/images/blog/search-relevance-ci.png
lang: ru
url: https://manticoresearch.com/ru/blog/search-relevance-ci/
translations:
en: https://manticoresearch.com/blog/search-relevance-ci/
zh: https://manticoresearch.com/zh/blog/search-relevance-ci/
---
# Регрессионное тестирование релевантности поиска в CI
Поиск может работать без ошибок, но показывать неправильный ответ первым. На примере Manticore покажем, как ловить такие проблемы в CI.
Поиск работает, но пользователь вводит ошибку доступа `E403` и получает инструкцию по обновлению токена. Запрос выполняется, результаты есть — только первая инструкция не решает проблему.
Проверка доступности сервиса этого не заметит. Тест, который считает только количество результатов, тоже. Нужны примеры вопрсов, разметка правильных ответов и проверка порядка документов в CI.
Вот [рабочий пример на Manticore](./search-relevance-ci/relevance-ci.zip). Мы сравним полнотекстовый, векторный и гибридный поиск, а затем уберём полнотекстовую часть. Результаты продолжат приходить, но их порядок ухудшится и проверка завершится с кодом **1**. В архиве — тестовые данные, оценки релевантности, скрипт проверки, ответы движка и пример для CI.
## Начнём с правильного ответа
В предыдущих статьях мы рассказывали о [гибридном поиске](/blog/hybrid-search/) и [разбиении документов на части](/blog/auto-chunking/). Теперь разберём другой вопрос: как убедиться, что после изменения поиска люди по-прежнему находят нужные ответы?
В нашем вымышленном API ошибка `E403` означает, что пользователю нужно выдать доступ, а `E401` — что истёк токен сессии. Высокая оценка сходства или слияния не показывает, какая инструкция действительно поможет. Это определяет приложение.
Мы взяли 12 коротких докуметов о вымышленных ошибках API и рабочих процедурах. Это учебные данные, не документация Manticore; коды ошибок тоже придуманы для примера. Для каждого запроса мы описали, что нужно найти, и оценили **каждый** документ:
| Оценка | Что она значит в этом примере |
|---|---|
| 2 | Содержит процедуру, которая решает заявленную задачу |
| 1 | Связанный контекст, но задачу не решает |
| 0 | Для этого намерения бесполезен |
Для `E403 API rejects my request` инструкция по выдаче доступа получает оценку 2. Обновление токена получает 1: тема похожая, но ошибку доступа это не исправит. Оценки мы выставили до запуска поиска, по смыслу документов. Независимую проверку они не проходили.
Оценка 1 учитывается в nDCG, потому что связанный материал тоже может быть полезен. Но похожая инструкция не обязательно решает проблему. Поэтому мы отдельно смотрим, насколько высоко стоит первый ответ с оценкой 2.
Для настоящего приложения соберите запросы из обращений в поддержку и частых пользовательских сценариев. Добавьте похожие, но неправильные ответы, попросите специалистов проверить оценки и сохрните разметку рядом с запросами в репозитории. Иначе тест может считать правильным совсем не то, что нужно пользователю.
## Небольшой набор запросов и фиксированные данные
В архиве четыре запроса для настройки и восемь контрольных запросов. Сначала на первой группе проверили работу поиска, затем оценили вторую. Ради лучших результатов на контрольной группе параметры не перебирали и примеры не меняли. В архиве есть итоговые данные и отчёты, но нет истории этих шагов с временными метками.
Обе группы ищут по тем же 12 документам, а один вопрос про код ошибки встречается дважды в разных формулировках. Поэтому контрольные запросы показывают, как работает проверка, но не подтверждают качество поиска на новых темах. Для реального проекта нужен отдельный и более широкий набор.
Чтобы повторить эксперимент, мы зафиксировали:
- Manticore **29.9.0**, зафиксированный по digest образа Docker `sha256:461b419739a2bbbffb4be0b32db26c41d7b435bf7fd1fce95b414ca5ccbb3775`;
- хеши корпуса, разделения запросов, полной матрицы оценок, схемы, настроек запросов и оценщика;
- `Xenova/all-MiniLM-L6-v2` в ревизии `751bff37182d3f1213fa05d7196b954e230abad9`, с проверкой SHA-256 для его конфигурации, токенизатора и модели ONNX;
- пять возвращаемых результатов, окно слияния 12, константа ранга RRF 10 и веса текста и вектора 2:1.
Manticore создаёт эмбеддинги документов и запросов локально, без облачного API. При первом запуске скрипт скачивает файлы модели по адресам конкретной ревизии и проверяет их хеши, а затем монтирует только для чтения. Фиксация ревизии защищает от изменения файлов, но не от исчезновения ссылки. Для долгоживущего CI лучше хранить проверенную копию модели.
Скрипт проверяет и то, что хранит сам Manticore: заново читает документы и выполняет `SHOW CREATE TABLE`. Так можно поймать изменения индекса, которых нет в исходных файлах.
## Сравниваем полнотекстовый, векторный и гибридный поиск
В `queries.json` для каждого запроса есть исходный текст и подготовленная строка для полнотекстового поиска. Если в запросе есть код ошибки, полнотекстовая часть ищет только этот код; для остальных запросов слова объединяются через OR (`|`). Сам скрипт не выделяет коды и не разбивает текст на токены. Векторный поиск получает весь запрос. Ни правильный ID документа, ни оценки релевантности в поиск не передаются.
Гибридный запрос объединяет оба списка результатов через [Reciprocal Rank Fusion (RRF)](https://manual.manticoresearch.com/Searching/Hybrid_search#Weighted-fusion-%28fusion_weights%29). Вес полнотекстовой части здесь вдвое выше веса векторной:
```sql
SELECT id, title, hybrid_score() AS score
FROM article04_docs
WHERE MATCH('E403') AS text
AND knn(vec, 'E403 API rejects my request') AS semantic
LIMIT 5
OPTION fusion_method='rrf', rank_constant=10,
window_size=12, fusion_weights=(text=2, semantic=1);
```
Для сравнения полнотекстовый вариант выполняет `MATCH()` с `ranker=bm25`, а векторный — `knn()` без `MATCH()`. Все три варианта оцениваются по одной разметке. Соотношение весов 2:1 выбрано для этого примера, не как общая рекомендация.
Вот результаты для восьми контрольных запросов. MRR@5 показывает, насколько высоко находится первый ответ, решающий задачу; nDCG@5 учитывает и связанные документы. Обе метрики объясним ниже.
| Путь поиска | MRR@5 | nDCG@5 |
|---|---:|---:|
| Лексический | 0.938 | 0.825 |
| Векторный | 0.844 | 0.922 |
| Гибридный (базовый вариант) | 0.938 | 0.955 |
В этом прогоне гибридный поиск получил лучший nDCG. Полезно сохранять резульаты всех трёх вариантов: если качество изменится, будет проще понять, проблема в полнотекстовой части, векторной или их объединении.
## Как мы оцениваем результаты
**MRR@5** оценивает позицию первого ответа с оценкой 2. Если он попал в первые пять результатов, для запроса берётся `1 / rank`, иначе — ноль. Затем считается среднее по запросам. Документ с оценкой 1 не считается решением проблемы.
**nDCG@5** учитывает весь список из пяти результатов: документы с оценкой 2 получают больше баллов, чем с оценкой 1, а нижние позиции — меньше:
```text
DCG@5 = sum((2^grade - 1) / log2(rank + 1)), ranks 1 through 5
nDCG@5 = DCG@5 / ideal DCG@5
```
Для идеального DCG скрипт сортирует по оценке **все размеченные документы** и берёт первые пять. Он не строит идеальный список только из того, что вернул поиск. Пропущенные позиции не дают баллов. Пустой список имеет значение метрики 0, но в этом примере пустой ответ движка дополнительно считается ошибкой.
В модульных тестах есть простой случай: сначала идёт документ с оценкой 1, затем правильный ответ с оценкой 2. Обратный ранг равен `0.5`, а nDCG — `(1 + 3/log2(3)) / (3 + 1/log2(3))`. Также проверяются граница первых пяти результатов, дубликаты, неизвестные ID и связанные документы, которые не решают задачу. Эти тесты помогают находить ошибки в самом скрипте оценки.
## Запросы работают, но проверка не проходит
Теперь уберём полнотекстовый поиск. Manticore всё ещё принимает запросы, строит эмбеддинги и возвращает документы. В примере ключ `--candidate` переключает гибридный поиск на чисто векторный, не подменяя оценки и не имитируя ошибку.
В таблице показаны все восемь контрольных запросов, в том числе те, где векторный поиск оказался лучше. RR — обратный ранг первого правильного ответа, nDCG учитывает и связанные документы.
| Запрос / намерение | RR@5 базовый | RR@5 кандидат | nDCG@5 базовый | nDCG@5 кандидат |
|---|---:|---:|---:|---:|
| h1: E401 request rejection | 1.000 | 1.000 | 0.945 | 0.945 |
| h2: E403 request rejection | 1.000 | 0.250 | 1.000 | 0.631 |
| h3: E507 snapshot failure | 1.000 | 1.000 | 1.000 | 1.000 |
| h4: E509 snapshot failure | 1.000 | 1.000 | 1.000 | 1.000 |
| h5: Recover a deleted document | 0.500 | 1.000 | 0.797 | 1.000 |
| h6: Keep erased content deleted after recovery | 1.000 | 0.500 | 0.933 | 0.797 |
| h7: Replace a schema while serving users | 1.000 | 1.000 | 0.964 | 1.000 |
| h8: Replace replication TLS credentials | 1.000 | 1.000 | 1.000 | 1.000 |
В h2 правильная инструкция по правам доступа падает с первого места на четвёртое, а обновление токена становится первым результатом. Зато в h5 векторный поиск улучшает выдачу: восстановление оказывается выше окончательного удаления. Но улучшение одного запроса не делает ошибку в другом приемлемой.
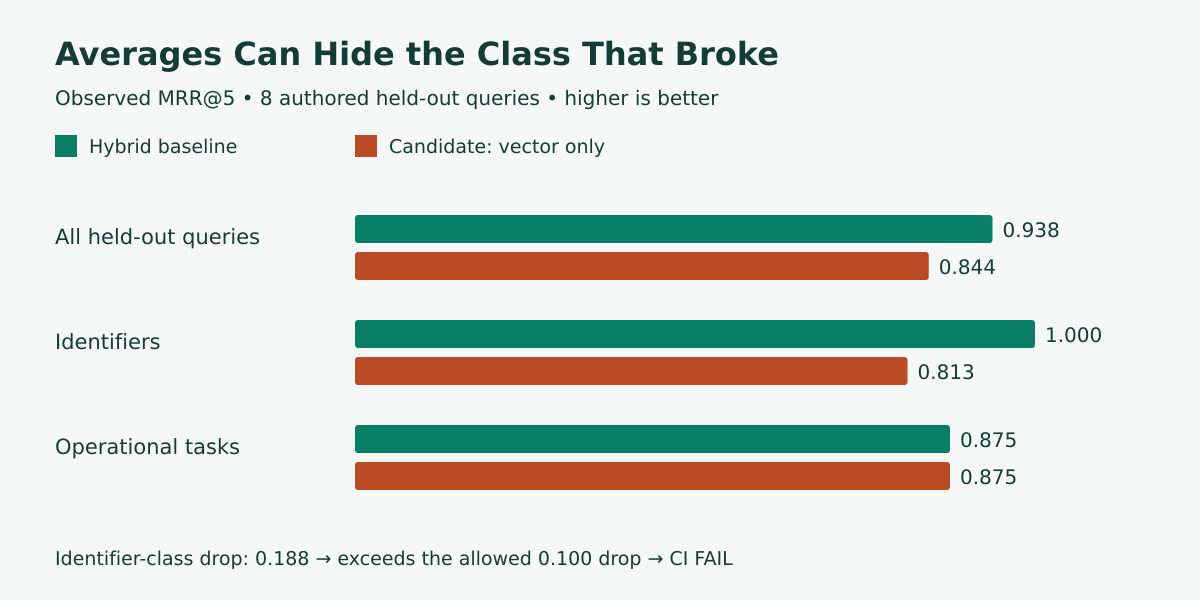
Общий MRR падает всего на 0.09375, поэтому правило с допустимым снижением 0.10 пропустило бы такой вариант. Но для запросов с кодами ошибок падение составляет 0.1875. Среднее по рабочим задачам остаётся 0.875: улучшение h5 компенсирует ухудшение h6. Одних средних значений недостаточно.
У нас три условия: nDCG отдельного запроса не должен падать больше чем на 0.20, MRR класса — больше чем на 0.10, а MRR каждого класса должен оставаться не ниже 0.60. Это пороги для демонстрации; в своём проекте выберите их по цене ошибки. Векторный вариант нарушает два условия:
```text
REGRESSION h2: nDCG@5 delta -0.369
REGRESSION identifier: MRR@5 delta -0.188
FAIL
```
При регрессии скрипт завершится с кодом 1, при ошибке настройки, проверки или самого движка — с кодом 2. Оба кода означают провал CI. Например, если указать в `ARTICLE04_PORT` закрытый порт, появится `ERROR: ` и код 2.
## Запускаем проверку локально и в CI
[Скачайте пример с результатами запуска](./search-relevance-ci/relevance-ci.zip), распакуйте его и откройте каталог `relevance-ci/`. Нужны Python 3.10+, Docker Engine и Compose v2. Пакетов pip устанавливать не нужно. По умолчанию используется локальный порт 49418; если он занят, задайте другой через `ARTICLE04_PORT`.
```bash
sha256sum -c SHA256SUMS
bash reproduce.sh
```
`reproduce.sh` проверяет модель, запускает проект Compose `manticore-article04` с ограничениями 2 CPU и 3 ГиБ и загружает таблицу примера. Затем он проверяет исходное ранжирование и запускает вариант только с векторным поиском, ожидая код 1. Демонстрация проходит, только если исходный вариант успешен, а регрессия обнаружена. Вывод команд и отчёты сохраняются.
Чтобы проверка блокировала CI, запустите её напрямую:
```bash
# Passes for the unchanged baseline:
python3 run.py check --out runs/baseline-check
# Intentionally fails with exit 1:
python3 run.py check --candidate --out runs/candidate-check
```
Каждый запуск `check` сохраняет ID документов, метрики и исходные HTTP-ответы движка (включая оценки поиска) рядом с пронумерованными SQL-файлами. Для каждого запуска нужен новый каталог: скрипт не перезаписывает прежние результаты. В каталоге `captured/` лежат результаты опубликованного прогона и негативных тестов. Чтобы включить `ci-example.yaml`, скопируйте его в каталог workflow вашего репозитория. **Пример специально запускает падающий вариант**, поэтому для реального CI замените эту команду.
С уже скачанной моделью три запуска `check` занимали по 0.37–0.39 секунды на загруженном общем Linux-сервере с 32 ядрами. Контейнер движка был ограничен 2 CPU и использовал около 189 МиБ памяти. Первый запуск скачивает около 87 МБ в `model-cache/`; сохранение этого каталога избавит от повторной загрузки.
Интеграционные проверки тоже запускаются:
```bash
python3 integration_negatives.py
```
`integration_negatives.py` проверяет отсутствующие оценки, повторяющиеся ID, изменённые входные данные, пустые результаты, ошибки движка и изменения корпуса или схемы прямо в Manticore. Последние два теста ненадолго меняют тестовую таблицу и восстанавливают её; после этого исходная проверка снова проходит. Запускайте их только в этом отдельном учебном проекте.
Когда закончите:
```bash
docker compose down -v
```
Эта команда удаляет контейнер, сеть и том данных этого примера. Скачанные файлы модели (около 87 МБ) и отчты остаются на диске.
## Когда обновлять эталонное ранжирование
Эталон — это утверждённый результат для определённого корпуса, модели и настроек запроса. CI должен сравнивать результаты с ним, а не создавать новый эталон автоматически. Если входные данные меняются, lock-файл должен требовать пересмотра.
Перед обновлением эталона просмотрите результаты каждого запроса. Если ухудшение задумано, объясните зачем. Затем сохраните новый эталон и обновите lock-файл по инструкции в README. Менять эталон только ради зелёного CI бессмысленно.
В примере построитель запросов и код оценки находятся вместе в `run.py`. Переключатель `--candidate` показывает одно изменение ранжирования, но не предназначен для любых правок построителя запросов. Если просто обновить `inputs.lock.json`, проверка отпечатка эталона всё равно не пройдёт. Для реального CI отделите изменяемый код запросов от зафиксированных данных оценки. Скрипт принимает только Manticore 29.9.0; при переходе на другую версию нужно обновить образ и lock-файл, а затем проверить ранжирование.
Это небольшой учебный тест на 12 вымышленных документах, а не замер качества поиска в продакшене. Он не проверяет масштабирование, задержки, генерацию ответов или права доступа. Приближённый поиск и одинаковые оценки могут по-разному вести себя на разных машинах, поэтому проверка допускает небольшие расхождения. Три прогона на одном сервере совпали; другие машины мы не проверяли.
Для своего приложения возьмите запросы, с которыми пользователи действительно обращались в поддержку. Попросите специалистов проверить оценки правильных ответов, задайте допустимые отклонения и изучайте отдельные неудачные запросы, а не только среднее значение.