Manticore Search 32.1.3 ускоряет загрузку больших объемов данных, улучшает полнотекстовый и векторный поиск и включает длинный список исправлений корректности и надежности. Главная новая возможность — массовый импорт напрямую на диск для локальных, шардированных и реплицируемых таблиц реального времени.
В статье собраны изменения, появившиеся после 29.9.0 , то есть в релизах с 29.9.1 по 32.1.3.
❤️ Благодарим @tudorvasinca (#4858 , #4924 , #4925 ), @vitlav (#5060 ), @RaphaelFakhri (#5031 ) и @drahy333 (Columnar #217 ) за вклад в развитие проекта.
Примечания по обновлению
Если вы не используете репликацию, специальная миграция не нужна. Сделайте резервную копию данных и обновитесь обычным способом.
Если вы используете репликацию, не обновляйте узлы по очереди при работающем кластере: старые и новые версии Manticore Search не могут работать в одном кластере. Приостановите запись, убедитесь, что все узлы синхронизированы, затем штатно остановите их по одному. Запомните, какой узел остановили последним. Пока все узлы остановлены, обновите Manticore Search на каждом из них. Затем первым запустите узел, который был остановлен последним, с помощью manticore_new_cluster (в systemd) или searchd --new-cluster. Остальные узлы запустите в обычном режиме и дождитесь синхронизации, прежде чем возобновить запись. Если весь кластер неожиданно отключился, вместо этого воспользуйтесь инструкцией по восстановлению кластера
.
Есть ещё одно изменение, которое вряд ли затронет большинство пользователей: теперь Manticore не запускается, если существующий файл manticore.json пуст. Этот автоматически обновляемый файл содержит сведения о real-time таблицах и кластерах. Изменение не даст повреждённому файлу незаметно сделать все таблицы недоступными. Если Manticore запускается без ошибок, ничего дополнительно проверять не нужно. Подробности — в разделе критических изменений
.
Массовый импорт напрямую на диск
При обычной загрузке через INSERT или /bulk документы становятся доступны для поиска сразу после COMMIT. Это удобно для постоянного потока данных, но при загрузке, например, большого архива логов обычно важнее скорость, чем поиск по ещё не загруженным документам. Режим массового импорта
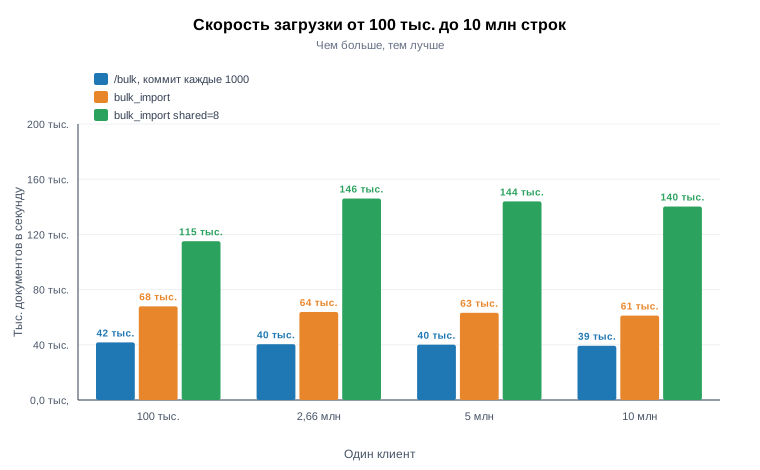
решает именно эту задачу: Manticore передаёт данные утилите indexer, которая строит дисковые чанки, и добавляет их в таблицу при COMMIT, не обеспечивая поиск по новым документам до фиксации загрузки. Это позволяет ускорить импорт и не держать весь пакет в RAM-чанке. На сервере с 6 ядрами, 12 потоками и 16 ГБ памяти 10 млн строк nginx-логов загрузились за 254 с через обычный /bulk, примерно за 164 с через bulk_import и за 71 с с shared=8. На графике ниже показана скорость при разных объёмах данных. Для локальной real-time таблицы SQL-импорт выглядит так:
SET bulk_import=products;
INSERT INTO products(id, title, price) VALUES
  (101, 'Notebook', 12.50),
  (102, 'Desk lamp', 24.00);
COMMIT;
SET bulk_import=0;
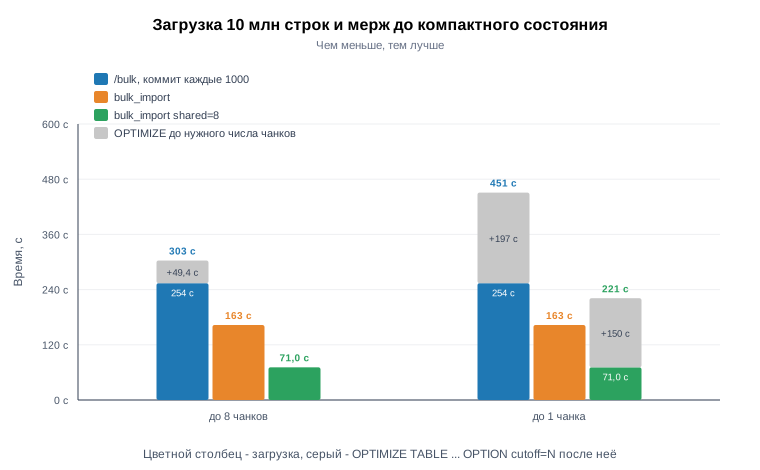
bulk_import также работает через HTTP-эндпоинт /bulk. При использовании shared параллельные клиенты передают данные в общий пул процессов indexer, а автоматически сгенерированные идентификаторы документов поддерживаются. Еще одно преимущество — меньше работы после загрузки: в том же тесте обычный /bulk оставил 17 дисковых фрагментов и один фрагмент в RAM, а их объединение в один фрагмент потребовало около 197 дополнительных секунд выполнения OPTIMIZE. Однократный коммит bulk_import сразу создал один дисковый фрагмент, а shared=8 — восемь. На графике выше учтено это дополнительное время оптимизации. Новый режим bulk_import поддерживает не только локальные таблицы реального времени, но и шардированные
и реплицируемые таблицы
. Координирующий узел направляет документы в шарды, а созданные дисковые фрагменты распределяются между репликами без предварительного импорта в отдельную локальную таблицу.
На время массового импорта Manticore резервирует соответствующую таблицу для загрузки: другие операции записи в неё недоступны, но поисковые запросы продолжают работать. Перед использованием в рабочей системе изучите документацию , особенно порядок фиксации импорта, очистки и обработки ошибок.
Ускорение полнотекстового и векторного поиска
Описанные в задаче #5110 оптимизации сокращают объём вычислений при обработке полнотекстовых запросов и не требуют изменения формата индекса:
- Для некоторых запросов
COUNT(*)по одному слову можно использовать счётчики словаря, а при более сложном подсчёте — пропускать этап ранжирования. - Некоторые запросы подсчёта с
OR/ANDи запросы без ранжирования обрабатываются блоками по 4096 строк с использованием битовых карт, адаптивных алгоритмов сопоставления и SIMD-инструкций с учётом возможностей процессора. - Ускорены декодирование списков вхождений и предварительная выборка данных. Если фильтр подходит ко всему чанку, его можно не применять; при
GROUP BYblob-данные могут загружаться заранее. - Теперь для
access_doclistsиaccess_hitlistsпо умолчанию используетсяmmap. Чтобы сохранить буферизованное чтение, задайтеfile.
Векторный поиск тоже стал эффективнее: улучшена предварительная выборка данных при рескоринге (в том числе при построчном хранении), ускорено параллельное построение HNSW во время FLUSH RAMCHUNK, оптимизированы KNN-запросы с фильтрацией. Эти изменения затрагивают разные сценарии, поэтому приводить одну цифру ускорения для всех запросов было бы некорректно.
Результаты тестов производительности
В проекте db-benchmarks сравнивались версии 29.9.0 и 32.1.2 с лимитом памяти 110 ГБ, при построчном и колоночном хранении. Использовались три разных набора данных: Hacker News — более 100 млн комментариев (полнотекстовый поиск и аналитика), Logs10m — 10 млн записей nginx-логов (типичные запросы к журналам веб-сервера), Taxi — 1,7 млрд записей о поездках такси и заказных автомобилей в Нью-Йорке (в основном аналитические запросы). Ниже приведено время выполнения запросов по метрике fast average (меньше — лучше).
Пять скриншотов показывают результаты отдельных запросов, а не общее ускорение всех операций. Мы считаем улучшение убедительным только там, где разница выделена красным цветом; бледно-розовая подсветка может означать погрешность измерений. Это не означает, что ускорились все запросы или все наборы данных.
Hacker News: отдельные запросы ускорились до 1,86 раза
При настроенном колоночном хранении время выполнения match('abc -google') сократилось с 13 до 7 мс (ускорение в 1,86 раза), а запроса с фильтрацией и группировкой — с 15 до 11 мс (в 1,36 раза). При настроенном построчном хранении тот же полнотекстовый запрос с исключением слова google ускорился с 12 до 7 мс (в 1,71 раза), а запрос с группировкой по автору публикации и сортировкой по количеству — с 576 до 482 мс (в 1,20 раза).
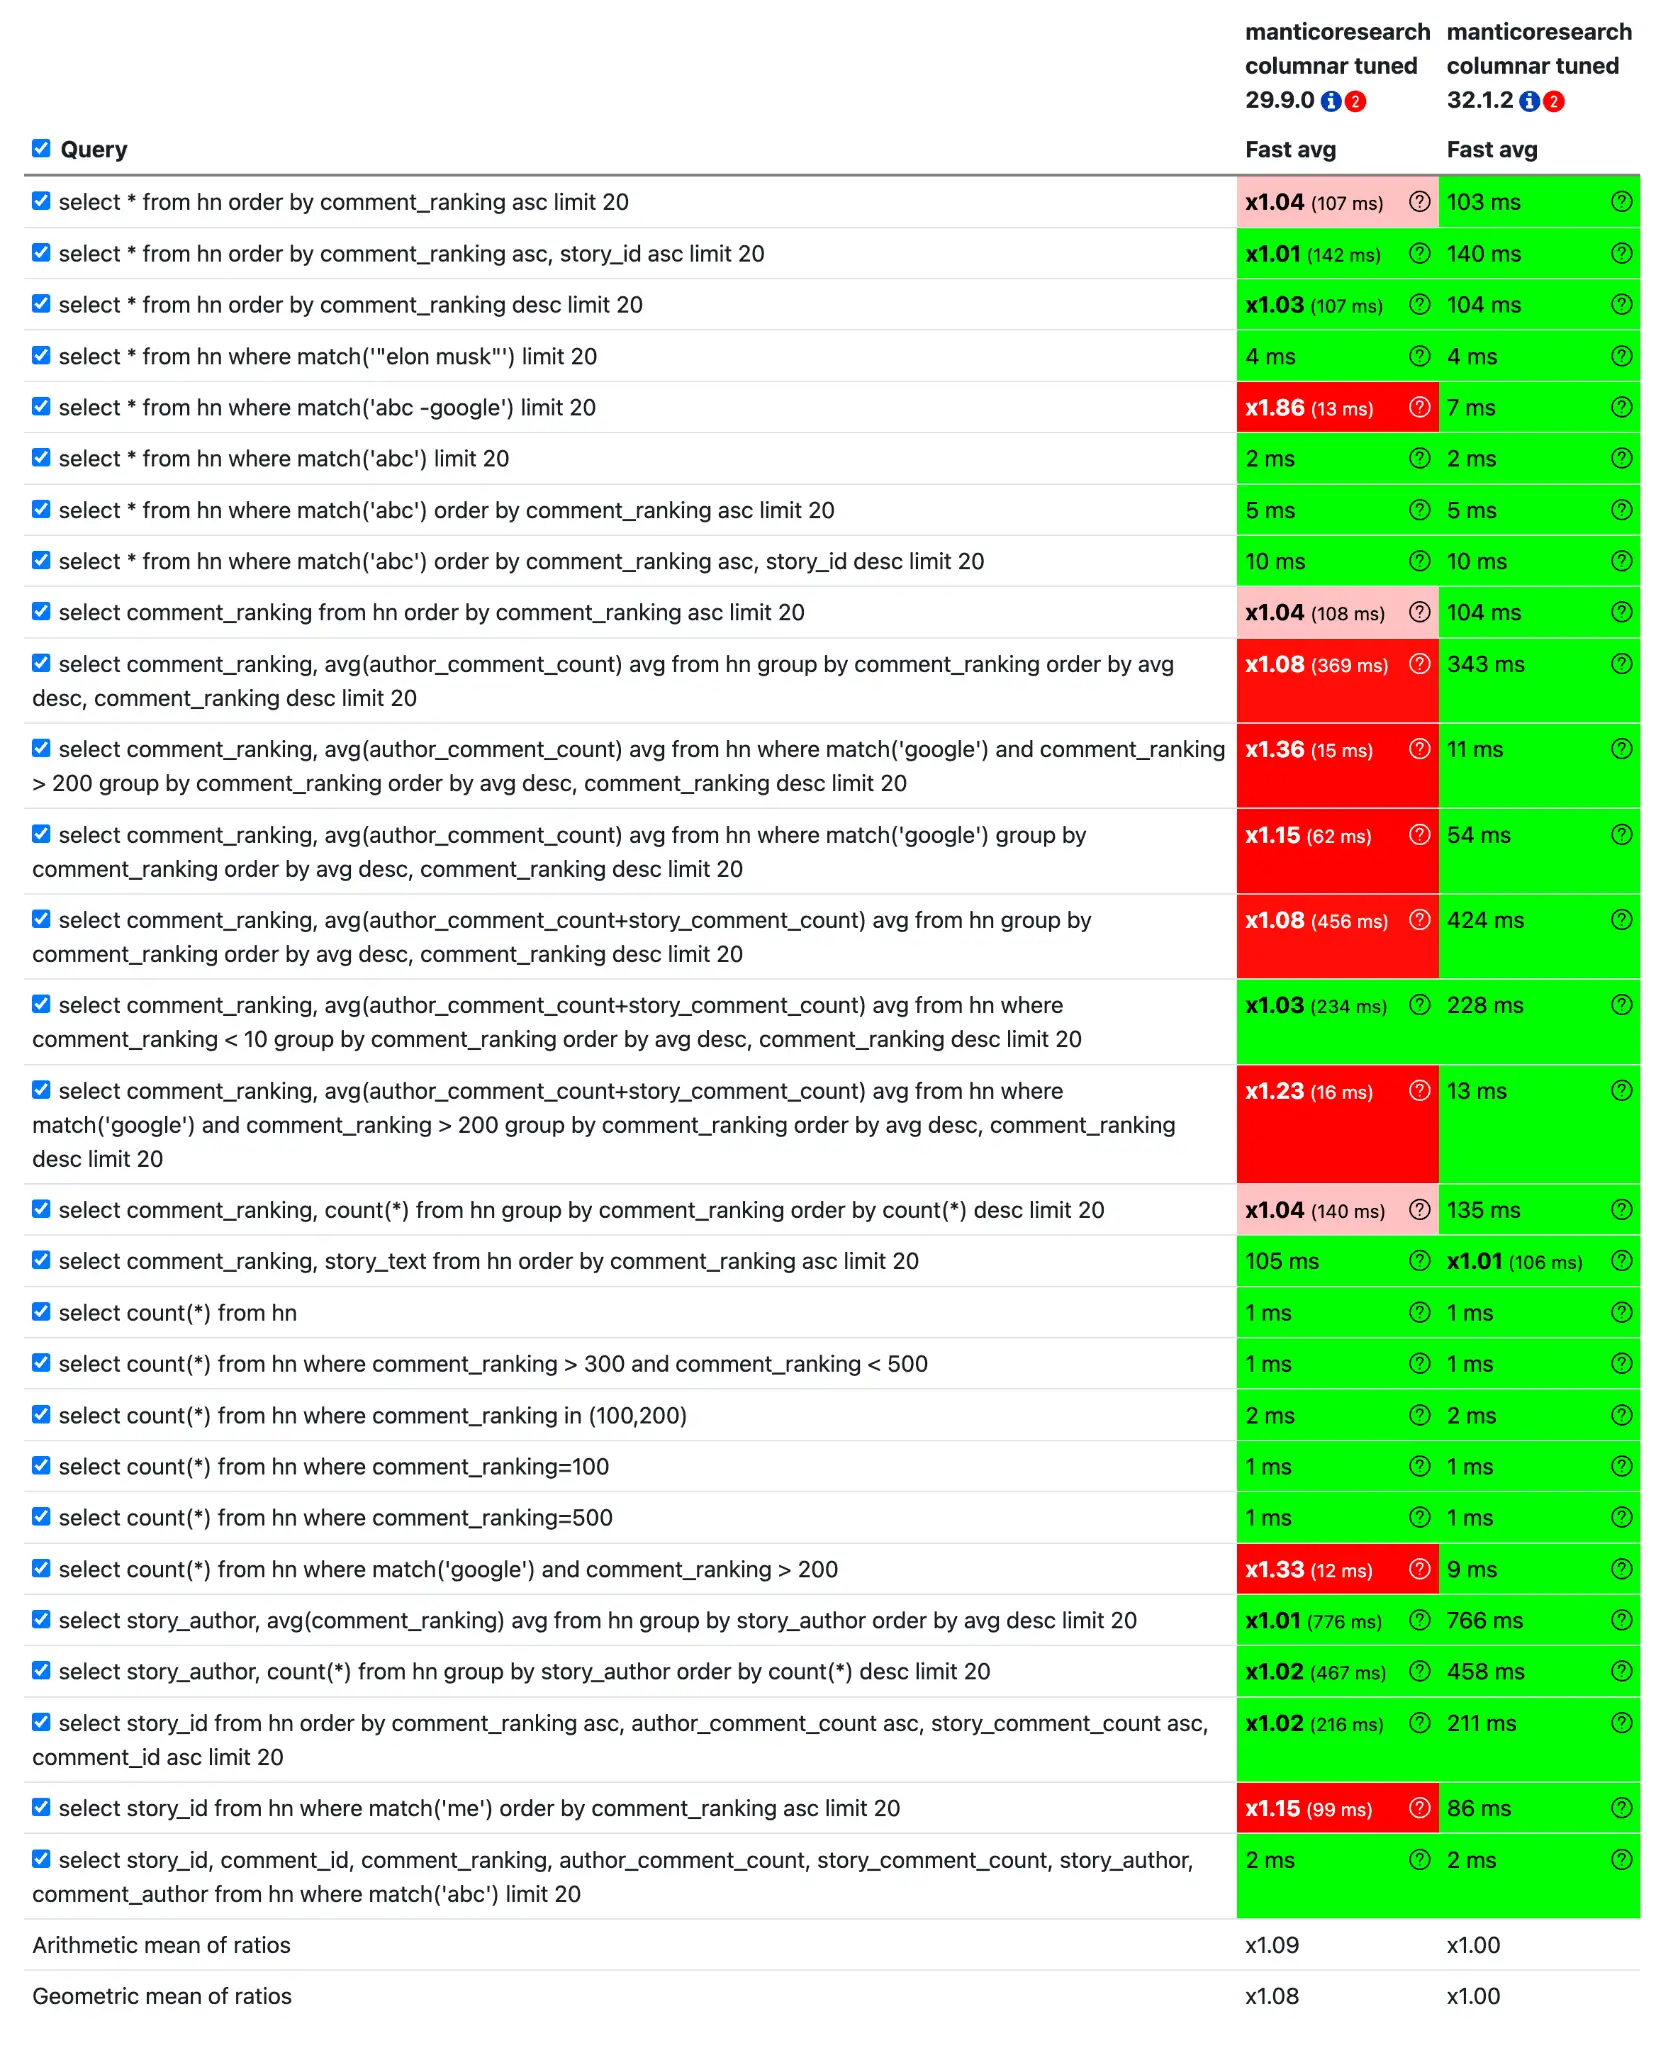
Hacker News, настроенное колоночное хранение: время выполнения запросов в версиях 29.9.0 и 32.1.2 (конфигурация 110 ГБ).
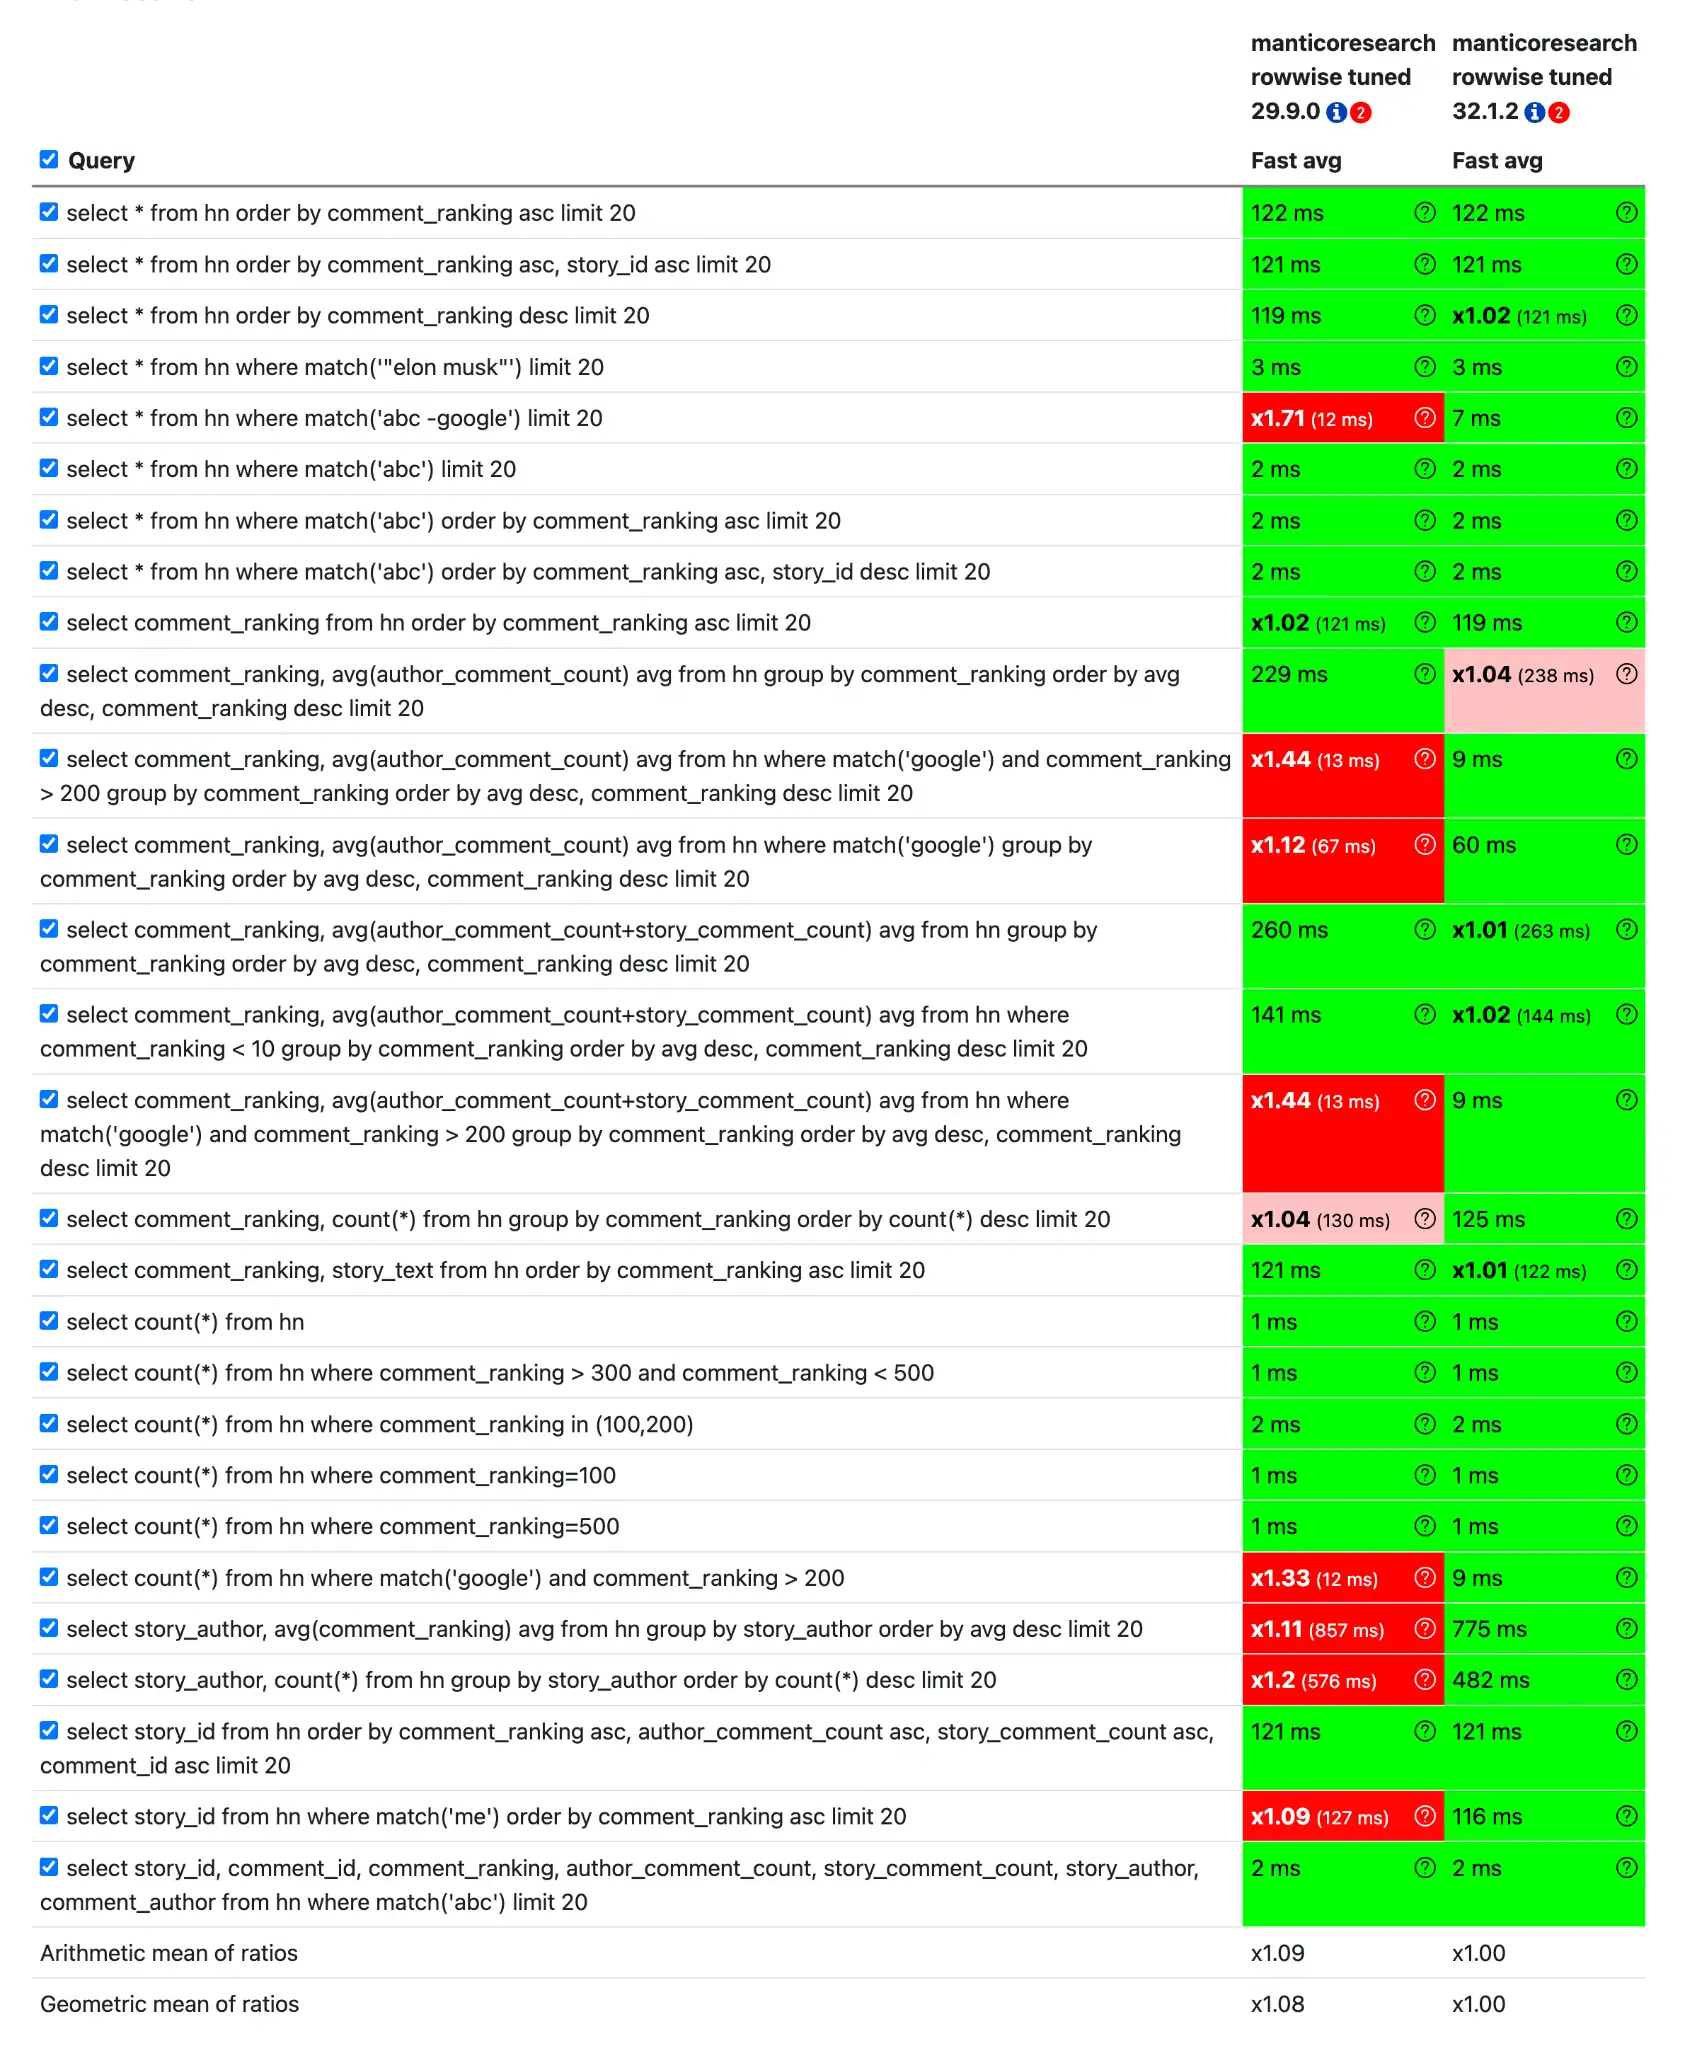
Hacker News, настроенное построчное хранение: время выполнения запросов в версиях 29.9.0 и 32.1.2 (конфигурация 110 ГБ).
Многие простые запросы к данным Hacker News в обеих версиях выполняются за 1–3 мс. Небольшие различия, не выделенные красным, не позволяют уверенно говорить об изменении производительности.
Logs10m: наибольшее ускорение — при группировке с построчным хранением
При построчном хранении логов запрос с группировкой по request_path и сортировкой по количеству ускорился с 221 до 121 мс (в 1,83 раза). Сортировка аналогичных групп по среднему времени выполнения ускорилась с 238 до 137 мс (в 1,74 раза).
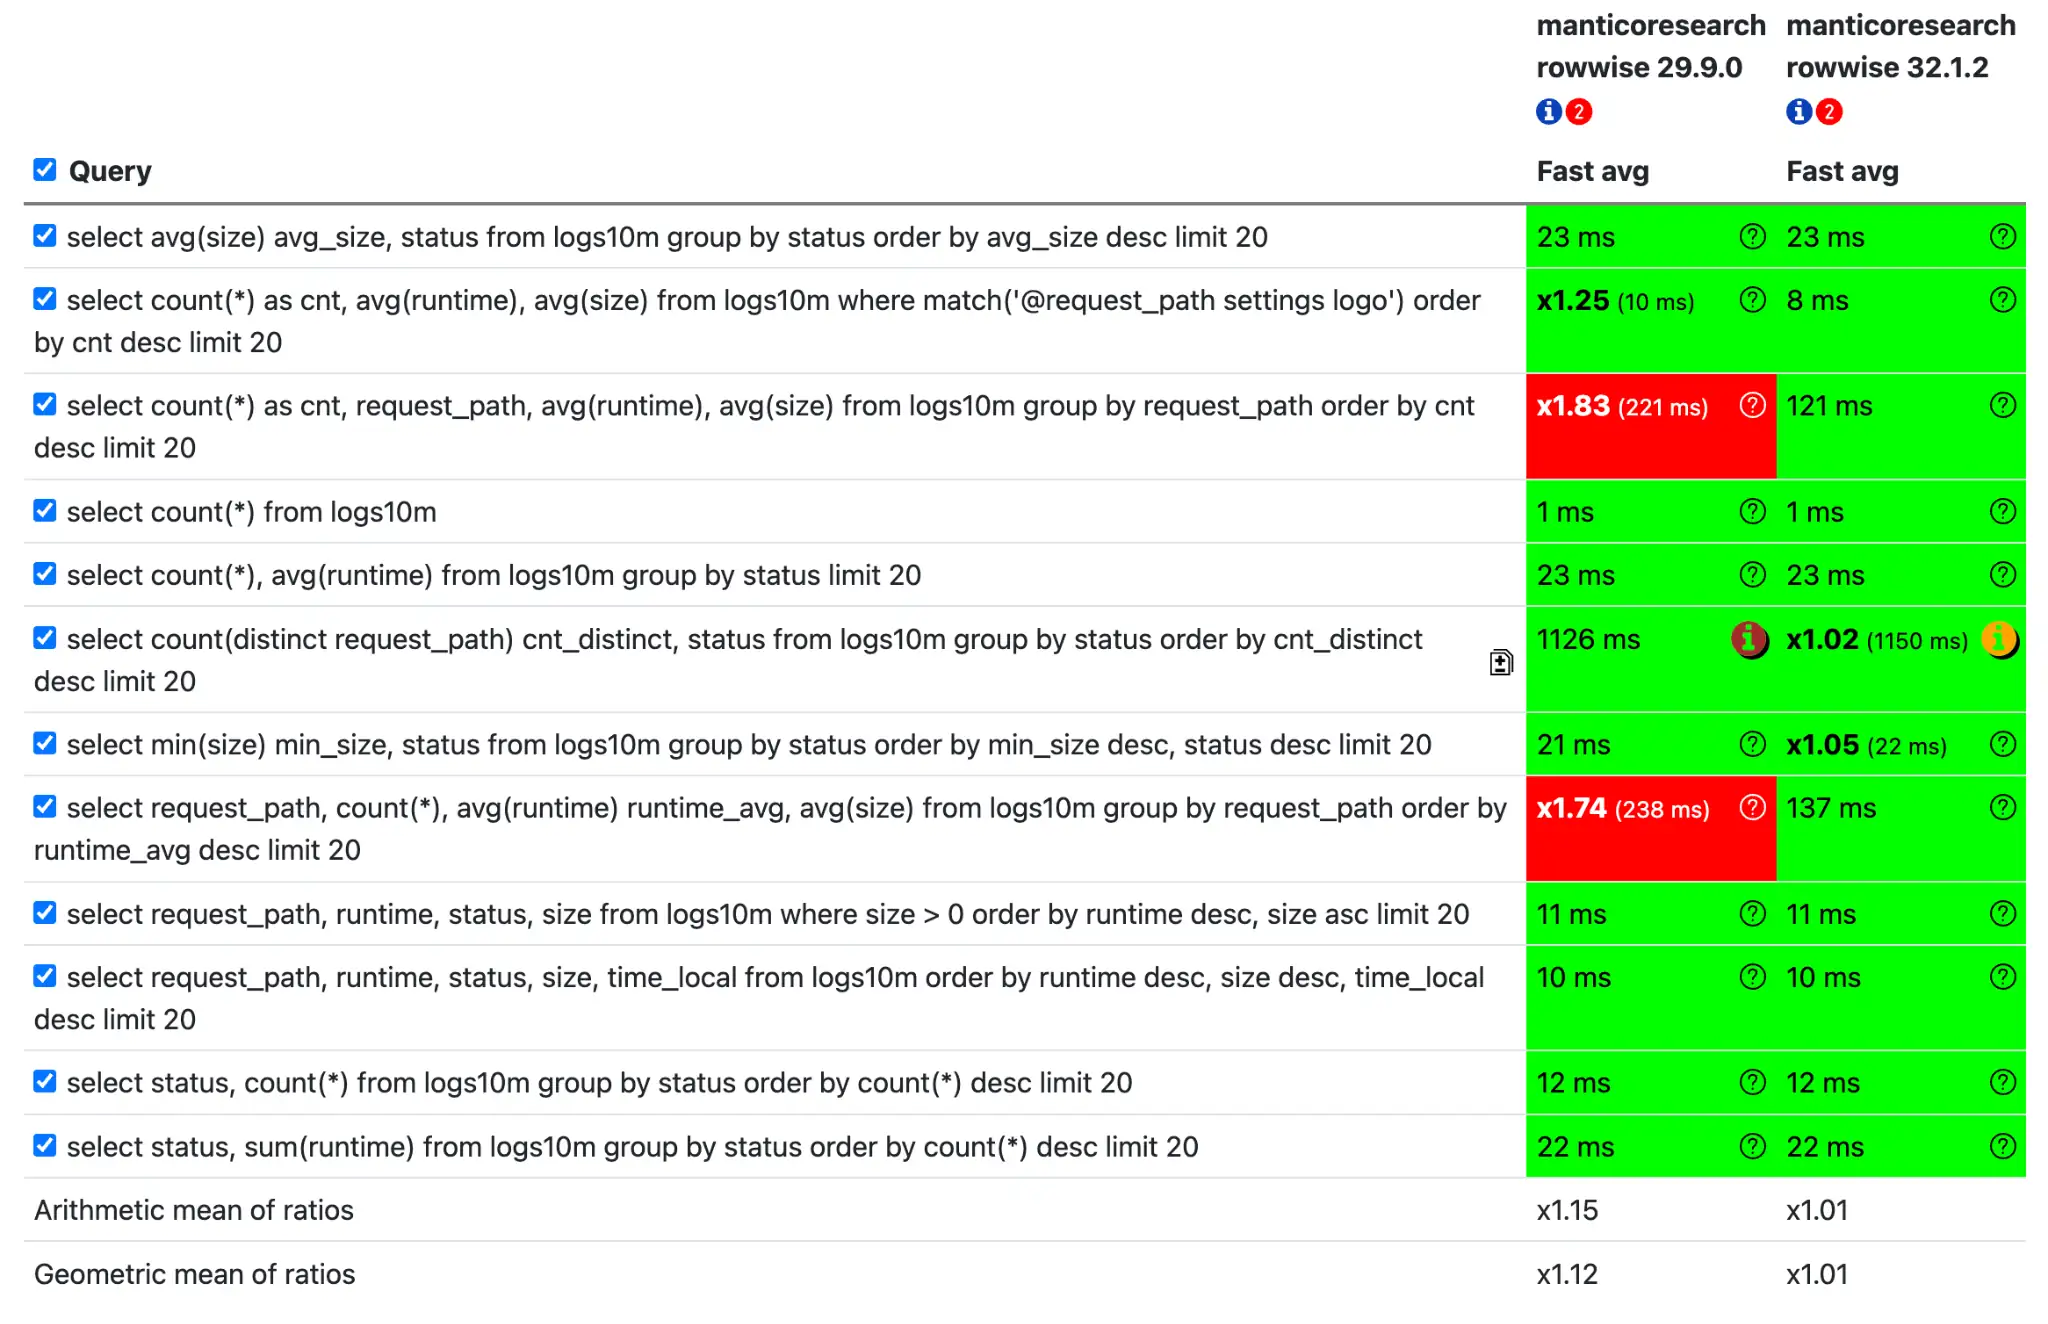
Logs10m, построчное хранение: время выполнения запросов в версиях 29.9.0 и 32.1.2 (конфигурация 110 ГБ).
При колоночном хранении время выполнения запроса GROUP BY status сократилось с 27 до 24 мс (в 1,13 раза). По большинству остальных запросов разница слишком мала для уверенных выводов.
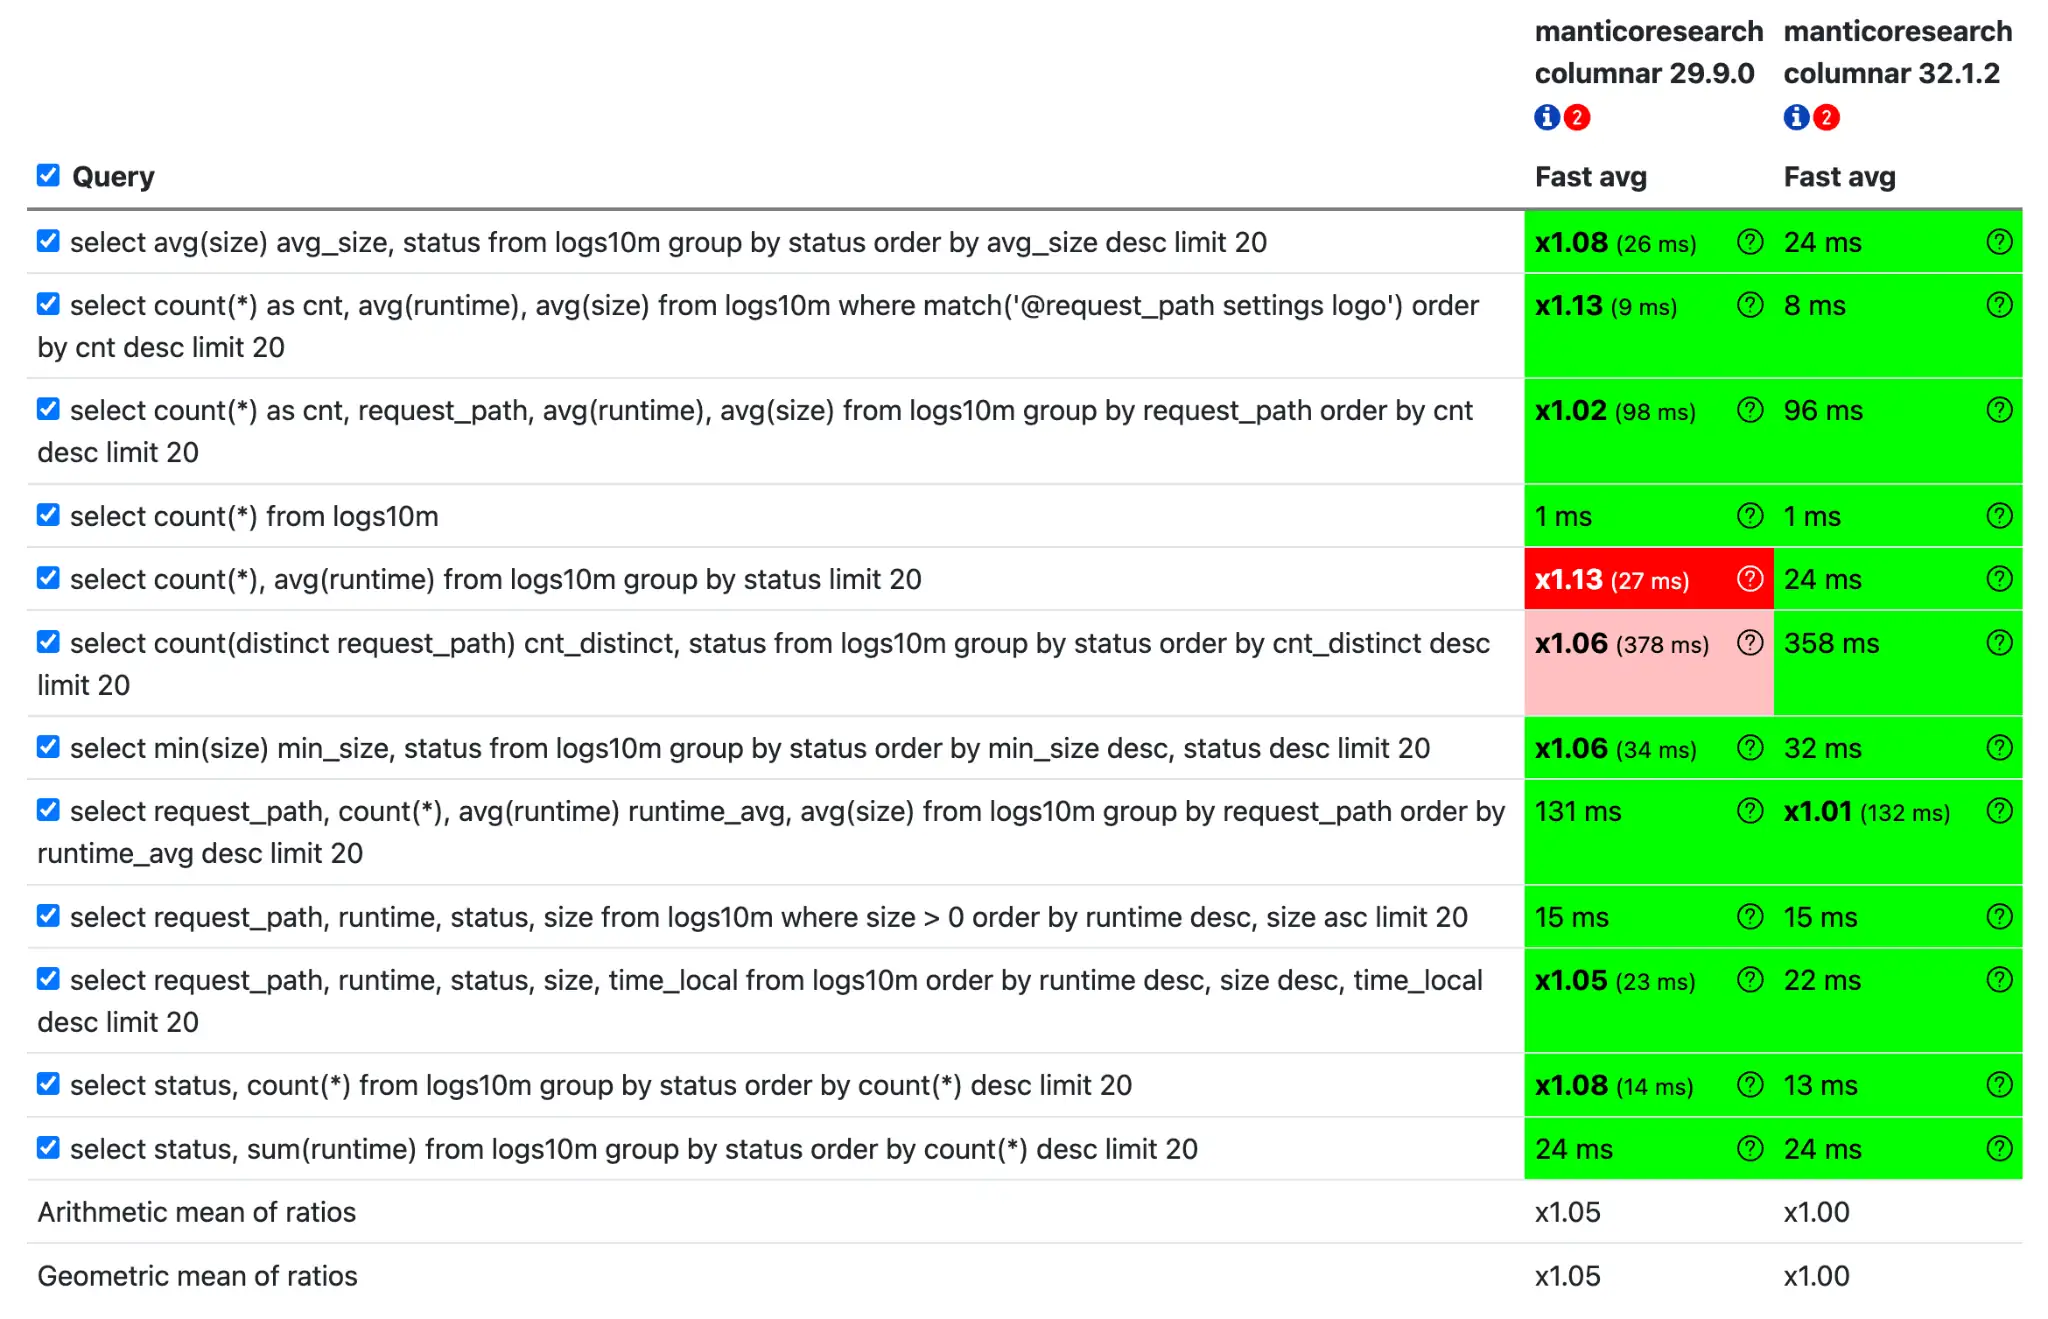
Logs10m, колоночное хранение: время выполнения запросов в версиях 29.9.0 и 32.1.2 (конфигурация 110 ГБ).
Taxi: ускорение полнотекстового поиска и агрегации
При настроенном колоночном хранении запрос MATCH('harlem east') ускорился с 255 до 172 мс (в 1,48 раза), а вычисление AVG(total_amount) по всей таблице — с 2 591 до 2 136 мс (в 1,21 раза). Красным также выделены улучшения нескольких запросов с группировкой и агрегацией.
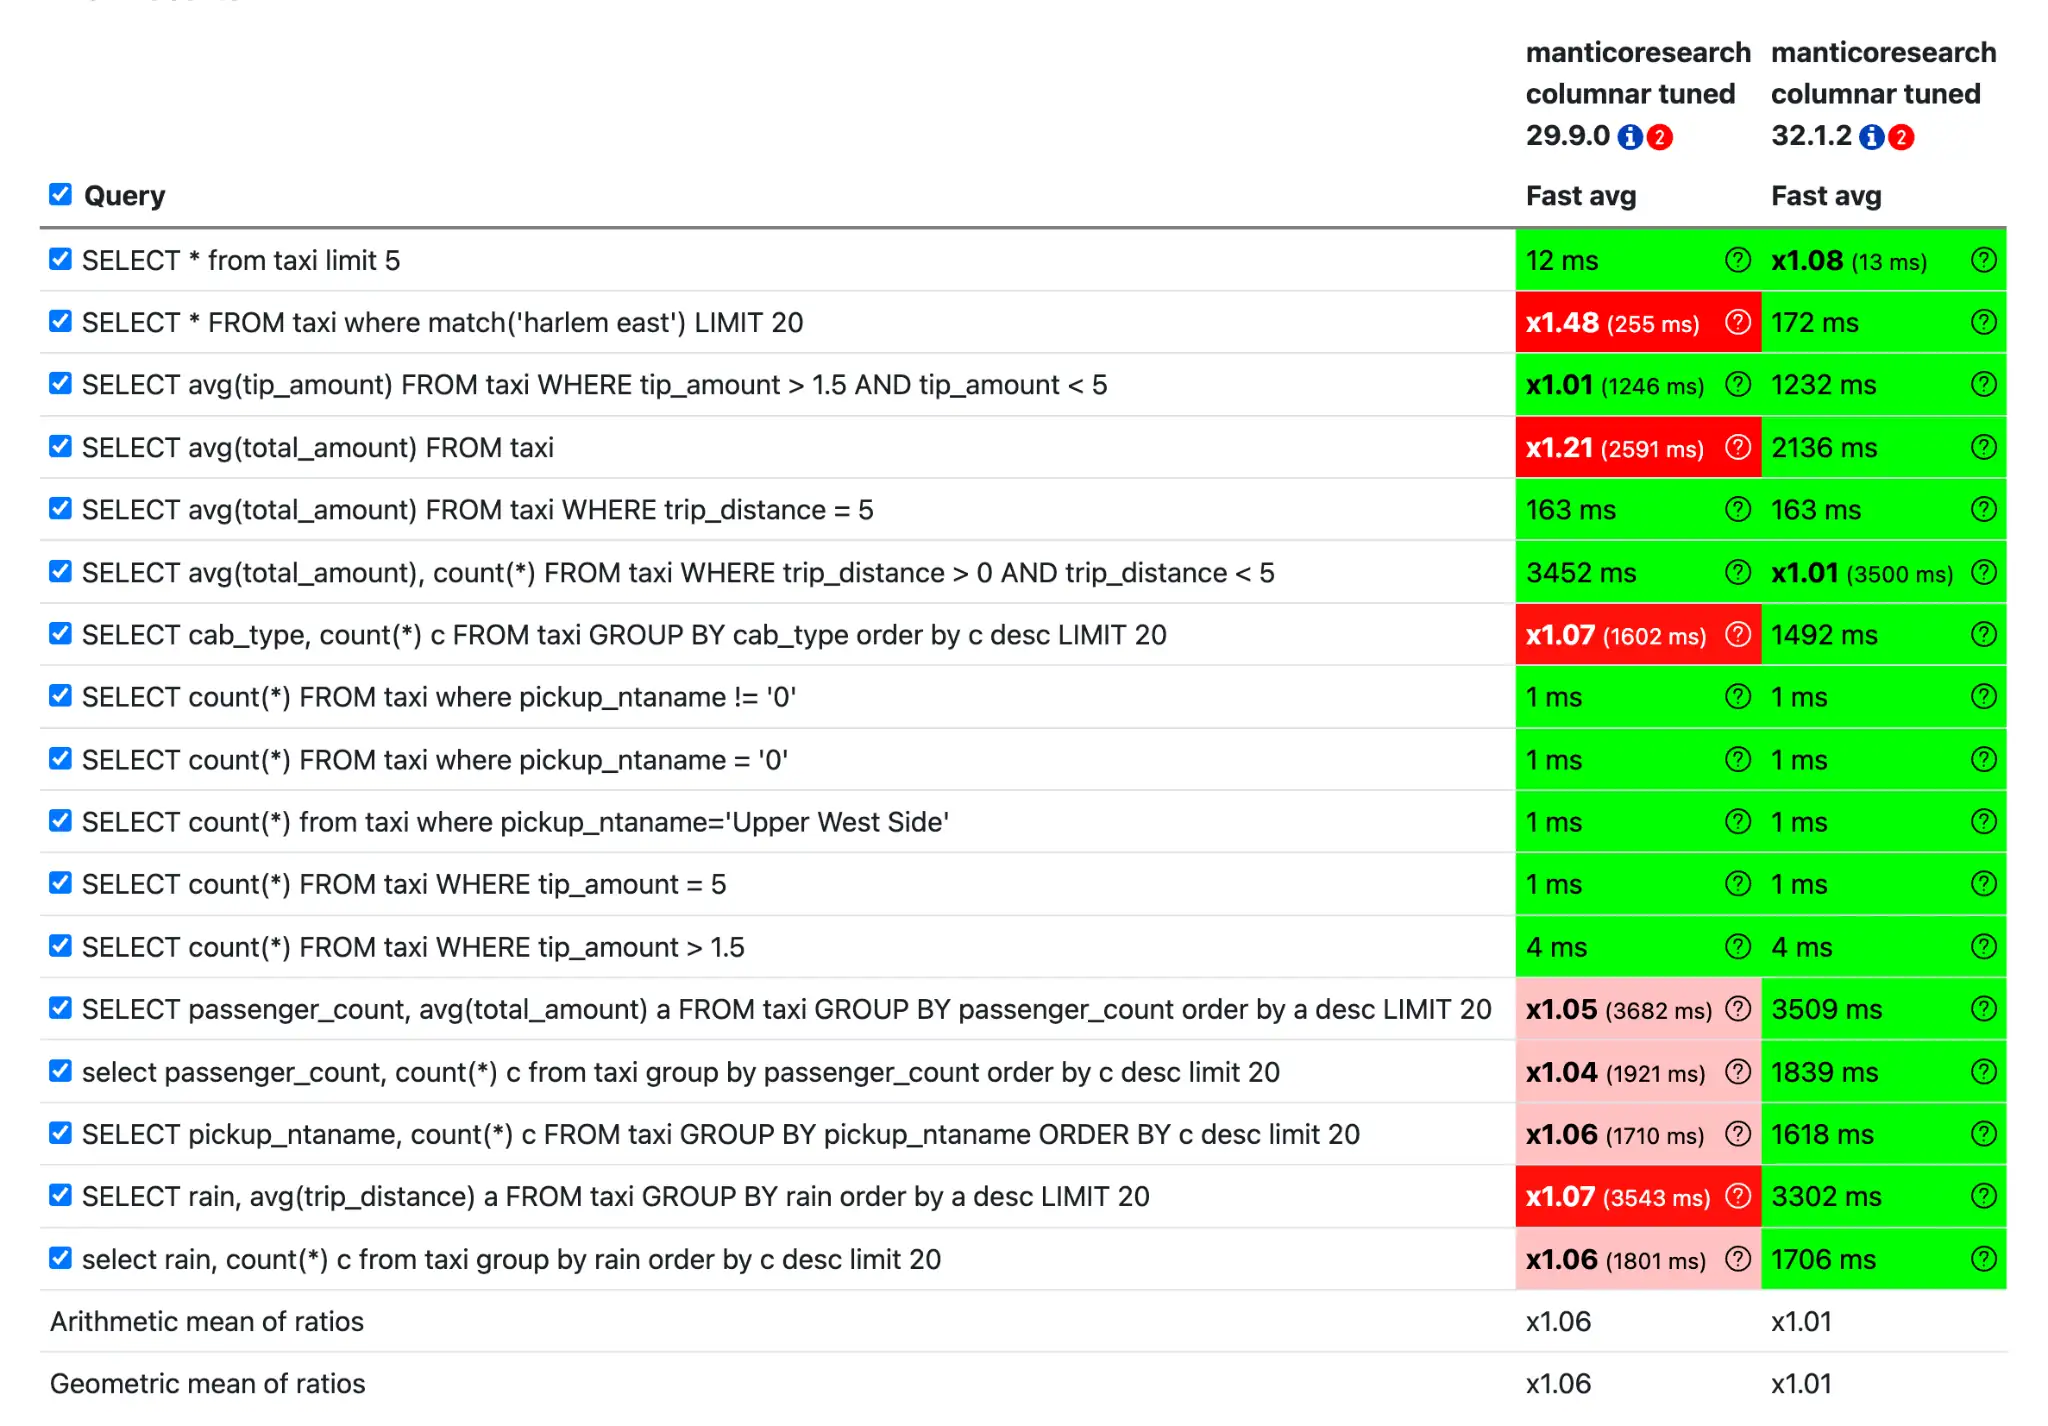
Taxi, настроенное колоночное хранение: время выполнения запросов в версиях 29.9.0 и 32.1.2 (конфигурация 110 ГБ).
Вывод: тесты показали заметное ускорение отдельных полнотекстовых запросов и запросов с группировкой, особенно на Hacker News и Logs10m с построчным хранением. Небольшие различия без подсветки или с бледно-розовой подсветкой не позволяют говорить ни об ускорении, ни о замедлении. В ваших условиях результаты будут зависеть от самих запросов, объёма доступной памяти и способа хранения данных.
Гибридный поиск, эмбеддинги и точность результатов
Гибридный поиск
теперь поддерживает фасеты по объединённому набору кандидатов полнотекстового и KNN-поиска. SQL-команда FACET и агрегации в JSON-запросах позволяют подсчитывать результаты по категориям во всём объединённом наборе, а не только среди строк, возвращённых с помощью LIMIT.
Автоэмбеддинги с разбиением текста на фрагменты теперь позволяют подсветить именно тот фрагмент, который соответствует векторному запросу. Так проще понять, почему длинный документ попал в результаты поиска.
Также исправлено множество ошибок, влиявших на корректность результатов. Фильтры по JSON и многозначным атрибутам теперь работают более согласованно при использовании вторичных индексов, колоночного и построчного хранения, SQL и HTTP. Исправления касаются ANY(), ALL(), фильтров по диапазону и исключению значений, а также COUNT(DISTINCT). Если вторичные индексы для JSON были созданы до этих исправлений, некоторые из них, возможно, потребуется перестроить командой ALTER TABLE ... REBUILD SECONDARY
, чтобы исправить сохранённые значения.
Повышение надёжности
Некоторые исправления особенно важны при использовании Manticore Search в рабочих системах:
- В Executor 1.4.9 включены исправления безопасности PHP 8.5.13 (PR #5121 ).
- Повышена надёжность сохранения реестра таблиц и кластеров (
manticore.json) при отключении питания. - Улучшены подключение реплик к кластеру, передача состояния и запуск кластера после полного отключения.
- Исправлены ошибки при записи перколяционных запросов и гонки при обновлении метаданных во время параллельного сброса данных на диск.
- Исправлены ошибки кэширования результатов запросов при псевдошардинге, а также некоторые сбои при колоночном и гибридном поиске.
- Улучшена диагностика сбоев при фоновых операциях, исправлены ошибки в
FREEZE,index_converterи отдельных случаях обработки протокола MySQL.
Полный список см. в истории изменений версии 32.1.3 .
Как установить Manticore Search 32.1.3
Чтобы установить или обновить Manticore Search, следуйте инструкции по установке . Если вы используете репликацию, перед перезапуском кластера выполните описанные выше действия.
Нужна помощь или хотите связаться с нами?
- Присоединяйтесь к нашему Slack-сообществу
- Загляните на форум
- Сообщайте об ошибках и предлагайте улучшения на GitHub
- Напишите нам:
[email protected]