
Допустим, вы делаете поиск по внутренней документации команды: руководству, рабочим инструкциям, разборам инцидентов. У вас есть таблица с автоматическим созданием эмбеддингов : вы вставляете текст, а Manticore запускает модель и заполняет значения эмбеддингов. (Если вы ещё не знакомы со всем этим - вот статья о векторном поиске в Manticore .) Вы загружаете документ на 4000 слов. Вставка проходит успешно. Поиск работает. Вроде всё в порядке.
Только вот выбранная модель принимает не более 512 токенов, а в документе их около 5000. Модель прочитала первые 380 слов, а остальные 3600 отбросила. По содержимому оставшейся части документ уже не найти. И не факт, что получившийся эмбеддинг будет отражать суть всего документа.
Раньше вам в таком случае обычно приходилось разбивать документ на несколько, для каждого отдельно строить эмбеддинги, затем как-то всё это объединять при поиске, если вы хотите на выходе иметь поиск документов, а не их фрагментов. Теперь в Manticore эту проблему можно решить просто: добавьте chunk_strategy к векторному столбцу прямо в CREATE TABLE, и Manticore разобьёт каждый документ на фрагменты, создаст эмбеддинг для каждого из них и будет искать по всем:
DROP TABLE IF EXISTS docs;

CREATE TABLE docs (
  title text,
  content text,
  chunks float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,content'
    chunk_strategy='sentence' max_tokens='256' overlap_tokens='32'
);
Вот и вся настройка. Не нужны ни конвейер загрузки, ни библиотека для разбиения текста, ни отдельная таблица для фрагментов, ни GROUP BY, чтобы собрать найденные фрагменты обратно в документы.
Коротко о главном
- Поддерживается пять стратегий:
truncate(прежний вариант по умолчанию),mean,fixed,recursive,sentence. Задаётся опциейchunk_strategyу векторного столбца с подключённой моделью. truncateиmeanсоздают один вектор на документ и работают со столбцомfloat_vector.fixed,recursiveиsentenceсоздают несколько векторов, поэтому им нужен столбецfloat_vector_array.- Один документ по-прежнему занимает одну строку в результатах поиска. Фрагменты участвуют в поиске независимо, а Manticore возвращает документ один раз. При этом
knn_dist()показывает расстояние до его ближайшего фрагмента.kзадаёт число документов, а не фрагментов. - Параметры настройки:
max_tokens(размер фрагмента),overlap_tokens(общие токены соседних фрагментов),max_chunks(максимальное число фрагментов на документ). - Измерения на документации Manticore (189 страниц, около 298 тыс. слов): для текста за пределами окна модели recall@5 вырос с 55,1% до 83,3%, а MRR - с 0,44 до 0,70.
- Запросы никогда не разбиваются на фрагменты. Запрос по определению считается достаточно коротким, чтобы его не разбивать; разбиение применяется только к хранимым документам.
Пример проблемы
Допустим, у вас есть 4 документа:
- Инструкция по резервному копированию и восстановлению - около 700 слов, примерно 900 токенов. Расписание копирования, сроки хранения, проверка восстановления, учётные данные, планирование ресурсов. В последнем разделе объясняется, как заменить TLS-сертификат, который используется на порту репликации.
- Руководство по мониторингу и оповещениям - к нашему вопросу не относится.
- Знакомство с клиентом командной строки - тоже не относится.
- TLS и сертификаты для HTTP API - короткая страница, целиком посвящённая сертификатам, но ни слова об их замене или репликации.
Создать таблицу и добавить документы можно используя команды приведённые ниже.
Итого, что у нас есть: одна таблица, три векторных столбца с одним и тем же исходным текстом - по столбцу на стратегию. Один INSERT заполняет все три, так что условия сравнения одинаковые:
DROP TABLE IF EXISTS docs;
CREATE TABLE docs (
  title text,
  body text,
  v_truncate float_vector       knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,body',
  v_mean     float_vector       knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,body' chunk_strategy='mean',
  v_sentence float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,body'
    chunk_strategy='sentence' max_tokens='128' overlap_tokens='32'
);
Вставляем 4 документа
INSERT INTO docs (id, title, body) VALUES
  (1, 'Backup and restore runbook',
   'Nightly backups run at 02:00 UTC from the standby node. The job snapshots every table directory, writes a manifest, and uploads the result to object storage. Retention is thirty daily copies, twelve monthly copies, and one yearly copy. A restore drill runs on the first Monday of each month against a scratch cluster. The drill counts as passed only when a full-text search over the restored data returns the same document count as production. Anything less is treated as a failed drill and investigated the same week. Before a restore, freeze the target cluster so that no writes land while files are being replaced. Copy the manifest first and verify its checksum. If the checksum does not match, stop: a partial restore is worse than no restore, because the cluster will start and silently serve half the corpus. After the files are in place, unfreeze and let replication catch up. Watch the queue depth. If it does not drain within ten minutes, the node is probably still reading from cold storage and needs a warm-up pass before it can serve traffic. Backup failures page the on-call engineer. The three most common causes are an expired object storage credential, a disk that filled up while the snapshot was being written, and a table left frozen by a previous failed run. All three are recoverable without data loss. Check the job log first, then the disk, then the freeze state of every table. Capacity planning for backups is boring but it matters. A daily copy of the search cluster is roughly the size of the data directory plus fifteen percent for the manifest and metadata. Multiply by the retention count, add the transfer cost, and you have the monthly bill. Most teams discover too late that the yearly copies dominate the storage line. Object storage lifecycle rules do most of the retention work. Daily copies move to infrequent access after seven days and expire after thirty. Monthly copies move to archive after sixty days. Yearly copies never expire automatically; deleting one is a manual action that requires a second approver. Credentials for the backup job live in the secret manager and are issued to a role, not to a person. The role can write new objects and list the bucket. It cannot delete, and it cannot read objects older than the current day. That last restriction is the cheapest defence against a compromised backup runner turning into a data exfiltration path. Documentation for each table lives next to its schema: what the table is for, who owns it, how large it is expected to get, and whether it can be rebuilt from an upstream source. A table that can be rebuilt does not need thirty daily copies. Roughly half of most clusters turns out to be derived data that nobody had marked as derived. Verification is not the same as the job exiting zero. The job can succeed while producing an unusable copy: an empty table, a truncated upload, a manifest that references a file that was never written. The verification step reads the manifest back, checks every referenced object exists and matches its recorded size, and compares row counts on three sampled tables against production. Rotating the replication TLS certificate is a separate procedure and the step people most often get wrong. The certificate that secures the replication port is not the same as the one the HTTP API uses, and replacing one does not replace the other. Generate the new key and signing request on the node that will be rotated first, sign them with the cluster certificate authority, and place the files next to the existing ones rather than on top of them. Then update the node configuration to point at the new paths and reload. Do one node at a time and confirm that the cluster reports every peer as synced before moving on. A half-rotated cluster where two nodes trust different authorities will keep accepting writes on both sides and diverge quietly. When every node has been rotated, remove the old key material and revoke the retired certificate at the authority.'),
  (2, 'Monitoring and alerting guide',
   'Every node exports metrics over an HTTP endpoint that a scraper collects once per fifteen seconds. The dashboards are grouped into four rows: traffic, latency, saturation, and errors. Traffic is queries per second broken down by table. Latency is the ninety-fifth and ninety-ninth percentile of query time, measured server side. Alerting is deliberately thin. Paging alerts fire on sustained error rate above one percent for five minutes, on ninety-ninth percentile latency above two seconds for ten minutes, and on a node dropping out of the cluster. Everything else is a ticket, not a page. Teams that page on every anomaly stop reading pages within a month. Log retention is fourteen days hot and ninety days cold. The query log records the query text, the table, the match count, and the elapsed time. Turning it on costs a few percent of throughput and is almost always worth it, because most performance investigations start with a slow query nobody knew was being issued.'),
  (3, 'Getting started with the CLI',
   'The command line client connects over the MySQL wire protocol, so any MySQL client works and you do not need to install anything special. Point it at port 9306 and you get an interactive shell. The shell understands the usual conveniences: history, tab completion of table names, and vertical output when a row is too wide for the terminal. Start by listing tables, then look at one with SHOW CREATE TABLE. The output is the exact statement that would recreate the table, including every option that was applied implicitly, which makes it the fastest way to find out what a table actually does rather than what someone documented two years ago. Bulk loading from the shell is possible but rarely what you want. For anything above a few thousand rows, use the HTTP bulk endpoint or one of the log shipper integrations, both of which batch and retry for you.'),
  (4, 'TLS and certificates for the HTTP API',
   'The HTTP API can be served over TLS. You supply a certificate, a private key, and optionally a chain file, and the listener starts speaking HTTPS instead of HTTP. Clients that present a certificate of their own can be authenticated by it, which is the usual way to lock an internal API down without putting a password in every config file. Certificates for the HTTP API come from wherever your organisation gets certificates: a public authority, an internal authority, or an automated issuer. The file format is PEM. Both the certificate and the key must be readable by the user the server runs as, and the key must not be world readable or the listener refuses to start. Debugging TLS problems is mostly about reading the handshake. A client that reports an unknown authority is missing the chain. A client that reports a hostname mismatch is connecting by an address that is not in the certificate. A client that hangs is usually talking TLS to a plaintext port.');
Теперь зададим вопрос, ответ на который находится в последнем разделе инструкции (документ "Backup and restore runbook") - по одному запросу для каждой стратегии:
SELECT title, knn_dist() FROM docs
WHERE knn(v_truncate, 4, 'how do I rotate the TLS certificate used for replication');

SELECT title, knn_dist() FROM docs
WHERE knn(v_mean, 4, 'how do I rotate the TLS certificate used for replication');

SELECT title, knn_dist() FROM docs
WHERE knn(v_sentence, 4, 'how do I rotate the TLS certificate used for replication');
| Стратегия | 1-й результат | 2-й результат |
|---|---|---|
truncate (по умолчанию) | TLS and certificates for the HTTP API - 0.762 | Backup and restore runbook - 0.936 |
mean | Backup and restore runbook - 0.656 | TLS and certificates for the HTTP API - 0.762 |
sentence, 128 токенов, перекрытие 32 токена | Backup and restore runbook - 0.254 | TLS and certificates for the HTTP API - 0.700 |
С truncate документ, в котором действительно есть ответ, проигрывает странице, которая лишь кажется подходящей, потому что посвящена сертификатам. Единственный вектор инструкции построен по её началу - расписанию резервного копирования и проверкам восстановления. Дальше модель просто не читала.
При разбиении по стратегии sentence для инструкции сохраняются девять векторов вместо одного:
SELECT id, title, LENGTH(v_sentence) AS chunks FROM docs ORDER BY id ASC;
+------+---------------------------------------+--------+
| id   | title                                 | chunks |
+------+---------------------------------------+--------+
|    1 | Backup and restore runbook            |      9 |
|    2 | Monitoring and alerting guide         |      2 |
|    3 | Getting started with the CLI          |      2 |
|    4 | TLS and certificates for the HTTP API |      2 |
+------+---------------------------------------+--------+
Один из этих девяти векторов соответствует абзацу о замене сертификата. Он почти точно совпадает с запросом по смыслу, поэтому документ побеждает с большим отрывом: дистанция 0.254 против 0.700.
Подробнее о стратегиях разбиения
| Стратегия | Векторов на документ | Тип столбца | Как работает |
|---|---|---|---|
truncate | 1 | float_vector | Создаёт эмбеддинг для текста, который помещается в окно модели, и отбрасывает остальное. Единственный режим доступный в старых версиях, вё ещё используется по умолчанию. |
mean | 1 | float_vector | Разбивает весь документ, создаёт эмбеддинг для каждого фрагмента и усредняет их в один вектор. |
fixed | N | float_vector_array | Разбивает текст на фрагменты фиксированного размера - по max_tokens токенов. |
recursive | N | float_vector_array | Разбивает текст по иерархии разделителей: абзац, строка, предложение, пробел. Каждый фрагмент укладывается в max_tokens. |
sentence | N | float_vector_array | Определяет границы предложений по Unicode UAX #29
и собирает предложения во фрагменты размером до max_tokens. |
Главное различие - не в том, где проходит граница фрагмента, а в том, что именно мы ищем.
Когда на документ приходится один вектор, поиск отвечает на вопрос: «Похож ли этот документ в целом на запрос?» Смысл одного подходящего абзаца теряется на фоне остального текста. А документ, в котором обсуждаются пять тем, в итоге толком не соответствует ни одной.
Когда у каждого фрагмента свой вектор, вопрос другой: «Есть ли в этом документе что-то похожее?» Каждый фрагмент оценивается отдельно, а Manticore возвращает документ один раз, с оценкой по лучшему фрагменту.
truncate - оставьте для коротких документов
title text,
v float_vector knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='title'
Так всё работало раньше и сейчас: chunk_strategy='truncate' используется по умолчанию, указывать его не нужно. Это подходящий, самый быстрый и самый экономный вариант, если текст действительно помещается в окно модели: названия товаров, короткие описания, теги, сообщения в чатах, строки логов, поисковые запросы, заголовки коммитов.
Сколько текста помещается? Больше, чем обычно кажется, но меньше, чем хотелось бы. all-MiniLM-L6-v2 принимает 512 токенов - примерно 380 английских слов. text-embedding-3-small - 8192 токена. Если длина документа у вас с запасом укладывается в лимит - оставляйте truncate.
Когда возникают проблемы: с любыми длинными текстами. Веб-страницами, страницами документации, статьями базы знаний, договорами, расшифровками записей, перепиской, вики-страницами, README-файлами, разборами инцидентов.
mean - один вектор, но для всего документа
v float_vector knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='title,content'
  chunk_strategy='mean'
Manticore разбивает документ, создаёт эмбеддинг для каждого фрагмента и усредняет полученные векторы в один нормализованный вектор. Затраты на хранение и поиск такие же, как у truncate: один вектор на документ, один узел HNSW. Но ни одна часть текста не отбрасывается.
Когда использовать:
- Нужно учитывать конец документа, но хранить больше векторов слишком дорого: например, корпус очень большой и всё упирается в объём памяти для индекса.
- Столбец имеет тип
float_vector, и изменить его нельзя. Например, вы добавляете столбец в существующую таблицу черезALTER, а стратегии с несколькими векторами этого не поддерживают. - Документы длинные, но посвящены одной теме: полное описание одного товара, один рецепт, одна вакансия.
Не используйте эту стратегию, если документ охватывает несколько не связанных между собой тем. Если усреднить векторы пункта договора о возмещении убытков и условий оплаты, получится вектор где-то между ними, не близкий ни к одному. В нашем тесте ниже mean дал примерно треть того прироста, который обеспечивает поиск по отдельным фрагментам. Улучшение заметное, но разница существенная.
fixed - просто и предсказуемо
v float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='content'
  chunk_strategy='fixed' max_tokens='256' overlap_tokens='32'
Текст разрезается через каждые max_tokens токенов независимо от того, что находится в этом месте. Число фрагментов напрямую зависит от длины документа, поэтому размер индекса можно оценить ещё до загрузки данных.
Используйте, если у текста нет надёжной структуры: результаты OCR, собранный с сайтов HTML с потерянными абзацами, автоматические расшифровки без пунктуации, выгрузки логов, минифицированный текст. Это также хороший вариант, если нужно просто и с минимальными затратами избавиться от обрезания документов.
Обратная сторона: граница может пройти по середине предложения, а у фрагмента, который начинается с середины мысли, эмбеддинг получается неудачным. Именно для этого нужен overlap_tokens - о нём ниже.
recursive - хороший вариант для обычных текстов
v float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='title,content'
  chunk_strategy='recursive' max_tokens='256' overlap_tokens='32'
Лимит токенов тот же, что у fixed, но граница каждого фрагмента сдвигается назад к ближайшему естественному разделителю. Сначала ищется пустая строка, затем перенос строки, конец предложения и, наконец, пробел. Фрагмент заканчивается там, где заканчивается часть текста, а не там, где закончился счётчик. При этом граница никогда не сдвигается дальше середины фрагмента, так что вместо текста не должна получится россыпь мелких обрывков мыслей.
Если вы пользовались RecursiveCharacterTextSplitter из LangChain, идея та же. Только здесь всё работает внутри Manticore, размер считается в реальных токенах модели, а не в символах, и ничего дополнительно устанавливать не нужно.
Для чего подходит: документация в Markdown и HTML, вики-страницы, базы знаний, статьи в блогах, README-файлы, структурированные отчёты - любые тексты, которые человек разбил на абзацы. В нашем тесте эта стратегия показала лучший результат для текста в глубине документов.
sentence - когда фрагмент должен сохранять законченную мысль
v float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='content'
  chunk_strategy='sentence' max_tokens='256' overlap_tokens='32'
Стратегия определяет границы предложений по алгоритму Unicode UAX #29 . Затем она последовательно собирает целые предложения во фрагмент, пока позволяет лимит токенов. Фрагмент не начинается и не заканчивается посреди предложения. Исключение - предложение, которое само длиннее лимита: в крайнем случае его приходится разбивать по токенам.
Для чего подходит: обращения в поддержку и переписка по почте, чаты и расшифровки встреч, юридические тексты и регламенты, новости, отзывы, аннотации медицинских и научных работ - всё, где обрыв предложения меняет или уничтожает смысл. Эту же стратегию стоит выбрать, если фрагменты затем будут передаваться в LLM: текст, обрывающийся на полуслове, плохо подходит для промпта.
sentence немного бережнее относится к границам текста, чем recursive: в наших тестах эта стратегия создавала меньше фрагментов, они были более цельными, а recall@5 оказался примерно таким же.
Три параметра настройки
chunk_strategy  = truncate | mean | fixed | recursive | sentence
max_tokens      = размер фрагмента в токенах; 0 (по умолчанию) = лимит самой модели
overlap_tokens  = общие токены соседних фрагментов; требуется ненулевой max_tokens
max_chunks      = максимум векторов на документ; 0 (по умолчанию) = без ограничений
max_tokens ограничивается реальной вместимостью модели. Если указать 4096 для модели с окном в 512 токенов, получится всё равно 512, а не ошибка. Меньшие фрагменты дают более точные совпадения, но больше векторов; большие - больше контекста на вектор, зато самих векторов меньше. Для английских текстов диапазон 128–512 подходит почти для всех задач. В основном тесте мы использовали 256.
overlap_tokens повторяет конец каждого фрагмента в начале следующего, чтобы предложение на границе хотя бы где-то сохранилось целиком. Обычно задают 10–20% от max_tokens. Manticore гарантирует продвижение по тексту: fixed и recursive ограничивают перекрытие половиной размера фрагмента, а sentence переносит в начало следующего фрагмента целые предложения из конца предыдущего общим объёмом не более overlap_tokens, при этом всегда продвигаясь хотя бы на одно предложение. Параметр требует явно заданного ненулевого max_tokens: перекрытие относительно «какого-то там лимита модели» не имеет определённого смысла, поэтому Manticore отклоняет такую настройку.
max_chunks ограничивает влияние аномально больших документов. Без него 400-страничный PDF, вставленный в одну строку, превращается в тысячи узлов HNSW. Если этот лимит задан, Manticore добавляет остаток текста в последний разрешённый фрагмент, а при создании эмбеддинга обрезает его до окна модели:
-- документ примерно на 600 токенов, фрагменты по 64 токена
chunk_strategy='fixed' max_tokens='64'                  -- 22 вектора
chunk_strategy='fixed' max_tokens='64' max_chunks='3'   --  3 вектора
Используйте этот параметр как защиту от исключительных случаев, а не как универсальный способ сэкономить память.
Как выглядит поиск
В запросе ничего не меняется относительно того, как работало раньше. Нет ни таблицы фрагментов, ни вложенного поля, ни объединения таблиц, ни GROUP BY. Вот полный пример:
DROP TABLE IF EXISTS notes;
CREATE TABLE notes (
  title text,
  body text,
  chunks float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,body'
    chunk_strategy='sentence' max_tokens='32'
);

INSERT INTO notes (id, title, body) VALUES
  (1, 'Certificate rotation',
   'The replication certificate is not the one the HTTP API uses. Generate the new key on the node being rotated and sign it with the cluster authority. Update the paths and reload, one node at a time, confirming every peer reports as synced before you move on.'),
  (2, 'Disk pressure',
   'When a data directory crosses eighty percent the merge scheduler stops compacting and the node starts refusing writes. Free space first, then trigger a manual OPTIMIZE. Adding a disk without draining the queue only postpones the problem.'),
  (3, 'Slow queries',
   'Turn the query log on before guessing. Most investigations end at a single query nobody knew was being issued, usually one that sorts on an unindexed attribute over the whole table.');

SELECT id, title, knn_dist() FROM notes
WHERE knn(chunks, 3, 'how do I replace an expiring certificate on every node');
+------+----------------------+------------+
| id   | title                | knn_dist() |
+------+----------------------+------------+
|    1 | Certificate rotation | 0.51039070 |
|    2 | Disk pressure        | 0.91703475 |
|    3 | Slow queries         | 1.02606630 |
+------+----------------------+------------+
Здесь намеренно задано небольшое значение max_tokens='32', чтобы даже эти короткие заметки разбились на фрагменты и на маленьком наборе данных было видно, как работают несколько векторов на документ. LENGTH() для векторного столбца показывает, на сколько частей разбит каждый документ:
SELECT id, title, LENGTH(chunks) AS n FROM notes ORDER BY n DESC LIMIT 5;
+------+----------------------+------+
| id   | title                | n    |
+------+----------------------+------+
|    1 | Certificate rotation |    2 |
|    2 | Disk pressure        |    2 |
|    3 | Slow queries         |    2 |
+------+----------------------+------+
Шесть векторов, три строки в ответе. Поиск работет согласно правилам описанным в документации в разделе «Несколько векторов на документ» :
- Документ подходит, если любой из его векторов близок к вектору запроса.
- Manticore возвращает каждый найденный документ ровно один раз.
knn_dist()- расстояние до его ближайшего фрагмента. kзадаёт число документов, а не векторов.knn(chunks, 3, ...)означает три документа.- Документ без векторов никогда не попадает в результаты.
Тот же запрос по HTTP:
POST /search
{
  "table": "notes",
  "knn": {
    "field": "chunks",
    "query": "how do I replace an expiring certificate on every node",
    "k": 3
  },
  "_source": ["title"]
}
...
{
  "_id": 1,
  "_score": 1,
  "_knn_dist": 0.51039070,
  "_source": { "title": "Certificate rotation" }
}
...
Все остальные возможности из раздела KNN работают как прежде: фильтрация, предварительная и последующая фильтрация, квантизация , досрочное завершение поиска и пересчёт оценок.
А польза есть? Результаты на нашей документации
Мы протестировали новую функциональность на документации к Manticore на английском. Это 189 страниц, около 298000 слов: от заметки на два абзаца до ченджлога на 39000 слов.
Запросы мы не отбирали вручную. Для каждой страницы взяли заголовки разделов, оставили только те, которые встречаются в документации один раз, и разделили их на две группы:
- Запросы к тексту в глубине страницы (419) - заголовки, которые находятся после первых примерно 1200 символов. Порог намеренно выбран с запасом: окно модели составляет 512 токенов, или около 2000 символов, поэтому часть этих запросов всё ещё относится к тексту, который
truncateчастично видит. Значит, разница ниже скорее занижена, чем завышена. - Запросы к началу страницы (88) - заголовки в пределах первых примерно 1200 символов. Контрольная группа: текст, который
truncateи так видит.
Попадание засчитывается, если KNN возвращает страницу, с которой взят заголовок, среди первых k результатов. Модель - Xenova/all-MiniLM-L6-v2 (384 измерения, окно 512 токенов), работает на ONNX-бэкенде Manticore
. Используется 32 потока. Для стратегий с несколькими векторами заданы max_tokens='256' и overlap_tokens='32'. Показатели качества для конкретного индекса детерминированы. Время измерялось по одному разу для каждой стратегии на машине без другой нагрузки.
Текст в глубине документа - то, ради чего нужно разбиение
| Стратегия | Векторы | Загрузка | Память индекса | hit@1 | hit@5 | hit@10 | MRR |
|---|---|---|---|---|---|---|---|
truncate | 189 | 21 с | 4.2 МБ | 33.7% | 55.1% | 63.2% | 0.44 |
mean | 189 | 72 с | 4.2 МБ | 43.9% | 65.2% | 74.7% | 0.54 |
fixed | 3,430 | 73 с | 9.5 МБ | 56.3% | 81.1% | 86.2% | 0.68 |
recursive | 4,664 | 86 с | 11.7 МБ | 58.7% | 83.3% | 89.5% | 0.70 |
sentence | 4,041 | 79 с | 10.6 МБ | 55.4% | 83.5% | 89.0% | 0.68 |
Благодаря разбиению recall@5 вырос с 55.1% до 83.3%, а правильный ответ поднялся выше в выдаче: MRR увеличился с 0.44 до 0.70. Из запросов, для которых truncate вообще не находил ответ в первой пятёрке, recursive справляется примерно с двумя третями.
mean оказывается примерно там, где и ожидалось: даёт около трети этого прироста без дополнительных затрат на хранение и поиск.
Начало документа - контрольная группа
| Стратегия | hit@1 | hit@5 | MRR |
|---|---|---|---|
truncate | 65.9% | 86.4% | 0.74 |
mean | 59.1% | 83.0% | 0.69 |
fixed | 60.2% | 83.0% | 0.71 |
recursive | 58.0% | 86.4% | 0.70 |
sentence | 56.8% | 85.2% | 0.69 |
Для полноты картины стоит внимательно посмотреть и на эту часть результатов. Для текста, который модель и так видела, truncate по-прежнему чаще ставит правильный ответ на первое место: 65.9% против 58.0% у recursive. Вектор всего документа отражает общую тему страницы, и если запрос касается темы, с которой она начинается, этот контекст помогает.
На первых пяти результатах разница исчезает: у recursive и truncate ровно по 86.4%. Получается, мы теряем несколько процентных пунктов точности первого результата для текста в начале документа, но получаем +28 пунктов полноты для остального. Для поиска по документации, базе знаний или для любой RAG-системы, которая передаёт в LLM 5–10 фрагментов, выбор очевиден.
Затраты
- Память индекса: выросла с 4.2 до 11.7 МБ, примерно в 2.5 раза больше, при увеличении числа векторов примерно в 25 раз. Векторы - лишь часть данных RT-таблицы. Построение графа HNSW по этим векторам при сохранении дисковых чанков и
OPTIMIZEтоже занимает больше времени, хотя Manticore задействует для этого все ядра . - Заливка данных: время выросло с 21 до 86 секунд для 189 документов. При разбиении эмбеддинги создаются для всего корпуса, а не для первых 380 слов каждого документа, поэтому время растёт соответственно. Это затраты на создание эмбеддингов: время самого разбиения на фоне работы модели незаметно.
- Время отклика на запрос: выросло с 6.3 до 8.5 мс на p50. HNSW справляется с 4664 векторами почти так же легко, как со 189. Почему - читайте в статье о двухпроходном HNSW, пакетном вычислении расстояний и AVX-512 .
Если вы используете платный API эмбеддингов, рост времени загрузки означает и рост счёта: теперь в модель отправляется весь корпус, а не только начало каждого документа, и вы платите за каждый токен. У локальных ONNX-моделей нет оплаты за токены - это одна из главных причин, по которым мы так старались их ускорить .
Рекомендации по выбору стратегии разбиения эмбеддингов
| Ваши данные | С чего начать |
|---|---|
| Заголовки, названия, короткие описания, теги, строки логов | truncate |
Длинные тексты на одну тему; или жёсткое ограничение по памяти; или уже существующий столбец float_vector | mean |
| Документация, вики, базы знаний, статьи, README-файлы | recursive, max_tokens 128–256 |
| Обращения в поддержку, переписка, расшифровки, юридические тексты, отзывы | sentence, max_tokens 128–256 |
| Результаты OCR, собранный с сайтов HTML, автоматические расшифровки, неструктурированные выгрузки | fixed, max_tokens 256, с перекрытием |
| RAG: фрагменты будут передаваться в LLM как контекст | sentence, max_tokens 384–512 |
В большинстве вариантов перекрытие не указано намеренно: в тесте ниже оно не дало измеримого улучшения на структурированных текстах, но увеличило число векторов. Добавляйте его, когда отдельная мысль в тексте часто оказывается разрезана: в неструктурированных расшифровках, результатах OCR, длинном повествовании без абзацев.
Какого размера должен быть фрагмент?
А вот размер фрагмента действительно влияет на результат. Зависимость простая: маленький фрагмент точнее передаёт одну мысль; большой содержит больше контекста, но каждая отдельная мысль в нём теряется. Абзац в глубине длинного документа становится доступен для поиска только тогда, когда фрагмент достаточно мал, чтобы у этого абзаца появился собственный вектор.
Мы сделали ещё один тест: режим recursive, те же 189 страниц документации Manticore, три размера фрагмент понноженные на три варианта перекрытия, те же 419 запросов к тексту в глубине страниц. Сразу видны две закономерности: чем меньше фрагменты, тем выше качество; перекрытие влияет на затраты, но не особо улучшает качество.
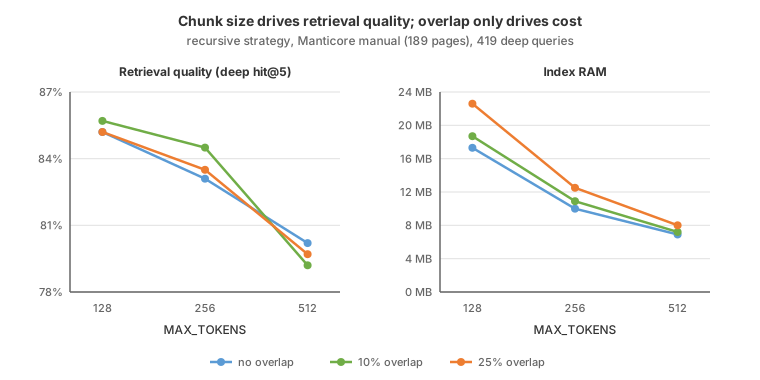
Обратите внимание: ось Y начинается с 78%, а не с нуля. Весь разброс - около шести процентных пунктов, поэтому при отсчёте от нуля графики выглядели бы почти прямыми. Вот данные для графика:
max_tokens | overlap_tokens | Векторы | Память индекса | hit@5 в глубине документа | MRR в глубине документа |
|---|---|---|---|---|---|
| 128 | 0 | 8,256 | 17.3 МБ | 85.2% | 0.718 |
| 128 | 13 | 9,328 | 18.7 МБ | 85.7% | 0.705 |
| 128 | 32 | 11,623 | 22.6 МБ | 85.2% | 0.694 |
| 256 | 0 | 3,984 | 10.0 МБ | 83.1% | 0.657 |
| 256 | 26 | 4,525 | 10.9 МБ | 84.5% | 0.681 |
| 256 | 64 | 5,569 | 12.5 МБ | 83.5% | 0.689 |
| 512 | 0 | 1,973 | 6.9 МБ | 80.2% | 0.655 |
| 512 | 51 | 2,191 | 7.2 МБ | 79.2% | 0.651 |
| 512 | 128 | 2,666 | 8.0 МБ | 79.7% | 0.660 |
Что видим:
Меньшие фрагменты стабильно выигрывают. Переход с 512 на 128 токенов даёт около пяти процентных пунктов recall@5 (с 80.2% до 85.2%) и заметно улучшает ранжирование (MRR с 0.655 до 0.718). Цена - в 4 раза больше векторов и в 2.5 раза больше памяти для индекса. При размере меньше 128 токенов фрагменты перестают вмещать законченную мысль, поэтому бесконечно уменьшать их нельзя. Но на длинных технических текстах 128–256 токенов каждый раз оказывались лучше 512.
Перекрытие почти не улучшило качество, но потребовало дополнительных ресурсов. При размере 128 токенов переход от нулевого перекрытия к 25% изменил recall@5 с 85.2% до тех же 85.2%, добавив при этом 41% векторов и 5 МБ памяти. Картина повторяется при всех размерах: разброс между вариантами перекрытия (±1.5 процентного пункта) укладывается в шум на наборе из 419 запросов, а рост затрат вполне заметен. Это согласуется с исследованием разбиения текста от Chroma : обычное рекурсивное разбиение по 200 токенов без перекрытия дало полноту 88.1% - всего на несколько пунктов меньше, чем разбиение с помощью LLM с результатом 91.9%. И это прямо противоречит совету «всегда используйте перекрытие 10–20%», который встречается в большинстве руководств по RAG.
Нужно оговориться: это один корпус, одна модель и запросы в виде заголовков разделов. Перекрытие оправдывает себя, когда отдельный факт часто попадает на границу фрагментов: например, в длинном сплошном повествовании или расшифровке без структуры. А recursive уже сдвигает границы к концам абзацев и предложений, во многом решая ту же задачу. Поэтому начните со 128–256 токенов без перекрытия и добавляйте его, только если измерения покажут пользу. Ниже - способ проверить это на своих данных.
Как сравнить варианта настроек
Если хотите на ваших данных и запросах добиться наилучшего результата, то мы рекомендум сравнить разные режимы. Для этого в одной таблице можно создать несколько векторных столбцов с подключённой моделью, каждый со своей стратегией. Все они заполняются из одних и тех же полей при одном INSERT:
CREATE TABLE ab (
  title text,
  body text,
  sent_256 float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,body'
    chunk_strategy='sentence' max_tokens='256' overlap_tokens='32',
  rec_128 float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,body'
    chunk_strategy='recursive' max_tokens='128' overlap_tokens='16'
);
Загрузите корпус один раз, затем выполните один и тот же запрос по каждому столбцу и сравните результаты. Например:
SELECT id, LENGTH(sent_256) AS sent_chunks, LENGTH(rec_128) AS rec_chunks FROM ab;
SELECT id, knn_dist() FROM ab WHERE knn(sent_256, 5, 'how do I rotate the replication certificate');
SELECT id, knn_dist() FROM ab WHERE knn(rec_128,  5, 'how do I rotate the replication certificate');
В нашем случае в короткой инструкции с разделом о сертификатах в конце стратегия sentence/256 помещает весь документ в один фрагмент и возвращает его с расстоянием 0.515. А recursive/128 делит его на две части, выделяет абзац о сертификате и возвращает документ с расстоянием 0.310. Та же строка, та же модель, тот же запрос - отличается только размер фрагмента.
В вашем случае соберите датасет из реальных запросов с ответами, за которые вы ручаетесь (хватит даже 50) и сравните recall@5 для двух-трёх столбцов, как мы сделали выше на документации. Затем удалите проигравший столбец через ALTER TABLE ... DROP COLUMN и оставьте лучший.
Готовые примеры
Поиск по документации и справочному центру. Длинные Markdown-страницы, пользователи задают вопросы своими словами. Разбивайте текст с учётом структуры и ищите по всем фрагментам:
CREATE TABLE docs (
  url string,
  title text,
  body text,
  chunks float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,body'
    chunk_strategy='recursive' max_tokens='192'
);
Обратите внимание на from='title,body': поля объединяются до разбиения, поэтому заголовок страницы попадает в первый фрагмент и добавляет ему контекст. Полный пример похожего решения - в статье «Векторный поиск по GitHub»
.
Обращения в поддержку и переписка по почте. Переписка состоит из законченных сообщений; если разрезать одно посреди предложения, можно потерять нужный факт. Ограничьте число фрагментов: у переписки нет естественного предела длины.
CREATE TABLE tickets (
  ticket_id bigint,
  customer string,
  status string,
  thread text,
  chunks float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='thread'
    chunk_strategy='sentence' max_tokens='256' overlap_tokens='32' max_chunks='64'
);

SELECT ticket_id, knn_dist() FROM tickets
WHERE knn(chunks, 10, 'customer was charged twice after upgrading')
  AND status = 'closed';
Фильтрация работает точно так же, как для столбца с одним вектором на документ.
Договоры и регламенты. Здесь весь смысл в поиске отдельных пунктов: пользователю нужен не просто «договор», а пункт о возмещении убытков. Подойдут небольшие фрагменты с большим перекрытием:
chunks float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='body'
  chunk_strategy='sentence' max_tokens='128' overlap_tokens='32'
Каталог товаров с длинными описаниями. Один товар - одна тема, а каталоги бывают большими. Можно обойтись без дополнительных затрат:
embedding float_vector knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='name,description'
  chunk_strategy='mean'
RAG: поиск для LLM. Найденный текст попадёт в промпт, поэтому фрагменты должны оставаться связными. Это поисковая часть разговорного поиска . Используйте фрагменты побольше, разбивайте по предложениям и запрашивайте больше результатов:
chunks float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='title,body'
  chunk_strategy='sentence' max_tokens='512' overlap_tokens='64'
Как добавить разбиение в существующую таблицу. Столбцы с несколькими векторами на документ нельзя добавить через ALTER. Стратегию с одним вектором добавить можно:
ALTER TABLE docs ADD COLUMN v2 float_vector knn_type='hnsw' hnsw_similarity='cosine'
  model_name='Xenova/all-MiniLM-L6-v2' from='title,body' chunk_strategy='mean';

ALTER TABLE docs REBUILD EMBEDDINGS v2;
Если нужен столбец с несколькими векторами, создайте новую таблицу с этим столбцом и заново проиндексируйте в неё данные.
Как это устроено в других движках
Сегодня каждый векторный движок умеет создавать эмбеддинги за вас. Гораздо меньше движков умеют перед этим разбить документ, а большинство из тех, что умеют, требуют собрать для этого конвейер из нескольких этапов.
| Движок | Создание эмбеддингов внутри движка | Разбиение внутри движка | Стратегии | Одна строка на документ в результатах поиска |
|---|---|---|---|---|
| Manticore Search | Да - локально + OpenAI / Voyage / Jina | Да - chunk_strategy у векторного столбца | truncate, mean, fixed, recursive, sentence | Да, встроено |
| Elasticsearch | Да - inference endpoints | Да | sentence (по умолчанию), word, recursive (9.1+), none | Да - semantic_text скрывает фрагменты |
| OpenSearch | Да - ML Commons | Да - отдельный процессор загрузки | fixed_token_length, fixed_char_length, delimiter | Нужны вложенное поле и вложенный запрос |
| Vespa | Да - встроенные модели эмбеддингов | Да - выражение при индексации | фиксированная длина, предложения, собственная логика | Да |
| Azure AI Search | Да - встроенная векторизация | Да - навык Split в наборе навыков | pages (символы), sentences | Нет - строка на каждый фрагмент |
| PostgreSQL + pgai | Да - фоновый процесс | Да | по символам, рекурсивно по символам | Нет - отдельная таблица, объединение и удаление дубликатов |
| Milvus / Zilliz | Да - Function (2.6+) | Нет - на стороне приложения | - | - |
| Qdrant | Да - Cloud Inference | Нет - на стороне приложения | - | - |
| Weaviate | Да - модули векторизации | Нет - на стороне приложения | - | - |
| Meilisearch | Да - модели эмбеддингов | Нет - на стороне приложения | - | - |
| Typesense | Да | Нет - открытый запрос на добавление | - | - |
| Apache Solr | Да - модуль LLM (9.8+) | Нет | - | - |
| Pinecone | Да - встроенный инференс | Нет - на стороне приложения | - | - |
| MongoDB Atlas | Да - Automated Embedding | Нет - на стороне приложения | - | - |
В ячейках столбца о разбиении приведены ссылки на источники. «Да» ведёт на документацию о соответствующей функциональности. «На стороне приложения» - на рекомендации самих разработчиков движка о том, как разбивать текст в приложении: именно такие материалы он публикует вместо встроенного решения. Если мы что-то упустили или с тех пор появилась новая возможность, сообщите нам , и мы исправим таблицу.
Проверенные версии - 4 сентября 2026 года
Последние стабильные версии продуктов на эту дату:
| Продукт | Версия |
|---|---|
| Elasticsearch | 9.5.3 |
| OpenSearch | 3.8.0 |
| Vespa | 8.750.13 |
| Azure AI Search | REST API 2026-04-01 |
| PostgreSQL + pgai | расширение 0.11.2 |
| Milvus / Zilliz | 2.6.23 |
| Qdrant | 1.19.0 |
| Weaviate | 1.38.13 |
| Meilisearch | 1.53.1 |
| Typesense | 30.2 |
| Apache Solr | 10.0.0 |
| Pinecone, MongoDB Atlas | облачные сервисы, фиксированной версии нет |
Здесь выделяются два момента.
Разбиение внутри движка всё ещё встречается редко. Milvus, Qdrant, Weaviate, Pinecone, MongoDB Atlas, Typesense, Meilisearch, а с появлением модуля LLM в версии 9.8 - и Apache Solr запустят за вас модель эмбеддингов. И каждый из них без предупреждения обрежет документ на 4000 слов. Разбиение остаётся вашей задачей: в вашем приложении, на выбранном вами языке, с библиотекой, которая ничего не знает о токенизаторе модели.
Даже когда разбиение есть, детали его реализации обычно приходится учитывать самому. В OpenSearch процессор text_chunking передаёт данные процессору text_embedding, тот записывает их во вложенное поле, а искать нужно вложенным запросом с выбором режима оценки. В Azure AI Search нужны набор навыков со Split, навык создания эмбеддингов и проекции индекса. При этом он возвращает отдельную строку на каждый фрагмент, так что группировать их обратно в документы придётся вам. pgai Vectorizer пишет фрагменты во вторую таблицу, поэтому каждый запрос требует объединения таблиц и DISTINCT ON. semantic_text в Elasticsearch действительно близок к подходу Manticore: настройки разбиения задаются на inference endpoint, фрагменты скрыты внутри поля, в выдаче - один результат на документ.
Manticore решает ту же задачу с меньшим числом настроек: стратегия задаётся параметром столбца, фрагменты хранятся в его значении, а поиск возвращает документы. Если вы сравниваете решения целиком, а не только эту возможность, у нас также есть сравнения с Elasticsearch и Turbopuffer .
Чего разбиение не решает
Разбиение хорошо решает одну задачу: документ длиннее окна модели больше не остаётся наполовину невидимым для поиска. Но идеальным поиск от этого не становится. Есть два известных ограничения.
Фрагмент не знает, откуда его взяли. После разбиения может получиться абзац «обрабатывайте узлы по одному и проверяйте, что все остальные узлы сообщают о синхронизации» - без указания, что именно заменяют и о каком продукте речь. В исследовании контекстного поиска от Anthropic эту проблему измерили: добавление перед каждым фрагментом краткого пояснения его контекста в документе до создания эмбеддинга сократило число случаев, когда нужный результат не попадал в первую двадцатку, на 35%, а в сочетании с контекстным индексом BM25 - на 49%.
Manticore не делает этого автоматически. FROM объединяет поля через пробел до разбиения, поэтому, если поставить title первым, заголовок окажется в начале общего текста - то есть только в первом фрагменте. Остальные фрагменты останутся без него:
-- 'title' идёт первым: его слова попадут во фрагмент 1, но не во фрагменты 2..N
from='title,body'
Если контекст нужен каждому фрагменту, к сожалению пока что остаётся только вариант с добавлением его в исходный текст самостоятельно до вставки. Например, повторяйте короткий заголовок в начале каждого раздела body. Отдельного параметра для префикса каждого фрагмента пока нет.
Границы фрагментов определяются до того, как модель увидит текст. Manticore сначала разбивает документ, а затем создаёт эмбеддинг для каждой части независимо. Это стандартный подход; так работают все движки со встроенным разбиением в таблице выше. Альтернатива - позднее разбиение, или late chunking , - меняет порядок: сначала модель с большим контекстным окном обрабатывает весь документ, а затем эмбеддинги токенов объединяются во фрагменты. Так вектор каждого фрагмента сохраняет контекст остального документа. Для этого нужна модель с большим контекстным окном и больше вычислений на документ. В Manticore такой возможности пока нет. Если смысл ваших документов сильно зависит от связей между абзацами, полезно знать об этом подходе.
Эти ограничения не меняют главного результата: на длинных документах поиск по фрагментам с большим отрывом выигрывает у поиска по обрезанному тексту. А чтобы его включить, достаточно добавить chunk_strategy к одному столбцу.
Ограничения и подводные камни
max_chunks отбрасывает текст. Manticore добавляет остаток в последний сохранённый фрагмент, а затем обрезает его до окна модели. Предупреждения не будет. Это защита от аномально больших документов, а не настройка для экономии памяти.
Для удалённых моделей размер считается в байтах, а не в токенах. Для OpenAI, Voyage и Jina нет локального токенизатора, поэтому Manticore использует заведомо осторожную оценку: 3 байта на токен. Это помогает уложиться в лимит провайдера. На практике max_tokens='N' превращается в окно размером N × 3 байта. Мы протестировал это на документе размером 3599 байт и стратегии fixed:
max_tokens | Размер окна в байтах | Число фрагментов |
|---|---|---|
| 100 | 300 | 12 |
| 200 | 600 | 6 |
| 400 | 1200 | 3 |
Для английского текста соотношение ближе к 4 байтам на токен, поэтому с удалённой моделью фрагменты получаются примерно на четверть меньше заданного размера. Чтобы получить сопоставимый результат, задайте max_tokens примерно на 30% больше, чем для локальной модели. Если важны точные границы, используйте локальную модель: для неё разбиение выполняется по реальным токенам.
Столбцы с несколькими векторами нельзя добавить через ALTER. Команды ALTER TABLE ... ADD COLUMN и ALTER TABLE ... REBUILD EMBEDDINGS для float_vector_array с подключённой моделью отклоняются. Нужно пересоздать таблицу. Для float_vector обе команды работают как обычно, в том числе со стратегией mean.
Разбиение работает только при автоматическом создании эмбеддингов. Векторы, которые вы вставляете самостоятельно, сохраняются как есть: Manticore никогда не разбивает переданные вами данные заново. chunk_strategy без model_name намеренно считается ошибкой DDL.
embeddings - зарезервированное слово. EMBEDDINGS используется как ключевое слово DDL (ALTER TABLE ... REBUILD EMBEDDINGS), поэтому столбец с именем embeddings без экранирования вызывает синтаксическую ошибку. Используйте экранирование.
Запросы не разбиваются на фрагменты. Для запроса целиком создаётся один вектор. Так и должно быть: разбиение нужно, чтобы находить длинные документы, а не делить вопрос из пятнадцати слов.
О несовместимых настройках DDL сообщает сразу, при CREATE TABLE, а не при первой вставке:
mysql> CREATE TABLE t (title text, v float_vector ... chunk_strategy='sentence');
ERROR 1064: chunk_strategy='sentence' produces several vectors per document
            and requires a float_vector_array attribute

mysql> ... chunk_strategy='fixed' overlap_tokens='32');
ERROR 1064: overlap_tokens requires an explicit non-zero max_tokens

mysql> ... chunk_strategy='paragraph');
ERROR 1064: unknown chunk_strategy 'paragraph'; expected truncate, mean, fixed,
            recursive or sentence

mysql> ... chunk_strategy='truncate' max_tokens='128');
ERROR 1064: chunk_strategy='truncate' ignores max_tokens, overlap_tokens and max_chunks
Пробуйте
Самый короткий путь к работающему семантическому поиску по фрагментам:
DROP TABLE IF EXISTS docs;

CREATE TABLE docs (
  title text,
  content text,
  chunks float_vector_array knn_type='hnsw' hnsw_similarity='cosine'
    model_name='Xenova/all-MiniLM-L6-v2' from='title,content'
    chunk_strategy='recursive' max_tokens='256' overlap_tokens='32'
);

INSERT INTO docs (id, title, content) VALUES
  (1, 'Backup and restore runbook', 'Nightly backups run at 02:00 UTC ... ');

SELECT id, title, knn_dist() FROM docs
WHERE knn(chunks, 5, 'how do I rotate the replication certificate');
Не нужно вручную скачивать модель, выбирать библиотеку для разбиения или обслуживать конвейер обработки. Один параметр столбца - и те части документов, которые раньше были невидимы для поиска, начинают появляться в результатах.
Подробное описание новой функциональности читайте в разделах документации «Стратегии разбиения» и «Несколько векторов на документ» . Вопросы и сообщения об ошибках оставляйте на GitHub .